Нейросеть для работы с данными: сервисы аналитики и ИИ-помощники
Обзор сервисов для анализа текстов, распознавания документов и видеоаналитики. Узнайте, как нейросеть для работы с данными решает бизнес-задачи.
Содержание статьи8
- Что умеет машинное обучение: основные сценарии обработки информации
- Обзор платформ для текстовой и бизнес-аналитики
- Решения для компьютерного зрения и распознавания документов
- ИИ-помощники для обучения и структурирования информации
- Как выбрать подходящий сервис: критерии и советы
- Типичные ошибки при внедрении ИИ-аналитики
- Пошаговый сценарий обработки информации с помощью ИИ
- FAQ: частые вопросы
Корпоративная среда, сфера образования и технологический сектор ежедневно генерируют колоссальные объемы информации, обработка которой традиционными ручными методами становится неэффективной и затратной. Сегодня на рынке представлены специализированные инструменты, такие как MonkeyLearn, Умка ИИ, Smart Engines, Преферентум, Tevian и bewise.ai, которые предлагают автоматизированные подходы к извлечению пользы из разрозненных массивов. Правильно подобранная нейросеть для работы с данными способна структурировать неформализованные тексты, распознавать удостоверения личности через камеры мобильных устройств, контролировать качество работы отделов продаж и выступать в роли интеллектуального репетитора для учащихся.
В данном материале мы проведем подробный разбор функциональных возможностей, технических особенностей и условий использования платформ, ориентированных на текстовую аналитику, алгоритмы компьютерного зрения и управление корпоративными коммуникациями. Мы изучим, как машинное обучение внедряется в электронный документооборот, видеоаналитику и CRM-системы. Для удобства сравнения все ключевые параметры сервисов, включая информацию о тарифах и доступности, собраны в сводной таблице ниже.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| MonkeyLearn | Анализ текста через ML-модели | Уточняйте на сайте сервиса | Уточняйте на сайте сервиса | Уточняйте на сайте сервиса |
| Умка ИИ | Личный ИИ-репетитор (вуз, школа) | Уточняйте на сайте сервиса | 5 запросов в день | Открывается без обходных путей, оплата: уточняйте на сайте |
| Smart Engines | OCR паспортов, документов, штрихкодов | Рассчитывается индивидуально | Уточняйте на сайте (демо по запросу) | Уточняйте на сайте сервиса |
| Преферентум | Анализ текста для ЭДО и аналитики | От 100 000 ₽ | Уточняйте на сайте сервиса | Открывается без обходных путей, оплата: уточняйте на сайте |
| Tevian | Видеоаналитика, распознавание лиц, KYC | Рассчитывается индивидуально | Уточняйте на сайте сервиса | Открывается без обходных путей, оплата: уточняйте на сайте |
| bewise.ai | Анализ продаж, CRM, контроль звонков | От 19 000 ₽/мес (скидки при оплате за год) | 0 ₽ навсегда | Открывается без обходных путей, российские карты принимаются |
Что умеет машинное обучение: основные сценарии обработки информации
Современные алгоритмы машинного обучения вышли далеко за пределы простых математических вычислений. Если раньше автоматизация касалась преимущественно работы с жестко структурированными базами, то сегодня фокус сместился на неструктурированные массивы: естественный язык, голосовые записи, видеопотоки и сканы документов. Бизнес-задачи требуют комплексного подхода, при котором система способна не просто прочитать символ, но и понять контекст происходящего.
Одним из важнейших направлений является текстовая аналитика. Ежедневно компании получают тысячи обращений в службу поддержки, отзывов на профильных площадках и комментариев в социальных сетях. Обработать этот поток вручную невозможно, поэтому применяются модели обработки естественного языка (NLP). Они определяют тональность сообщения, выделяют ключевые сущности (имена, названия компаний, даты) и автоматически маршрутизируют тикет на нужного специалиста. В сфере корпоративного документооборота аналогичные технологии используются для автоматического разбора договоров, счетов и актов, извлечения из них реквизитов и сумм для последующей передачи в учетные системы.
Не менее значимым сегментом является компьютерное зрение (Computer Vision). Алгоритмы научились с высокой точностью находить объекты на фотографиях и видеозаписях. Это открывает широкие перспективы для ритейла, банковского сектора и систем безопасности. Распознавание лиц применяется для верификации клиентов (процедуры KYC — Know Your Customer), что позволяет открывать банковские счета дистанционно. Анализ видеопотока с камер наблюдения помогает контролировать соблюдение техники безопасности на производстве, подсчитывать трафик посетителей в торговых центрах и выявлять внештатные ситуации в режиме реального времени. Распознавание текста на изображениях (OCR) позволяет мгновенно переносить данные с пластиковых карт, паспортов или автомобильных номеров в цифровой вид, минимизируя ошибки ручного ввода.
Третий масштабный сценарий — речевая аналитика и контроль коммуникаций. Интеллектуальные агенты интегрируются с корпоративной телефонией и CRM-системами, переводя голос в текст и анализируя диалоги менеджеров по продажам с клиентами. Система проверяет соблюдение скрипта, выявляет использование слов-паразитов или конфликтных формулировок, оценивает отработку возражений и формирует итоговую оценку звонка. Это дает руководителям объективную картину работы отдела без необходимости прослушивать часы аудиозаписей лично.
Для узкоспециализированных задач, связанных с математическим моделированием и табличными вычислениями, существуют свои инструменты. Если вас интересует обработка классических числовых массивов, рекомендуем ознакомиться со статьей Нейросеть для Excel и таблиц: формулы и анализ данных. Однако в рамках данного обзора мы сфокусируемся на сервисах, которые извлекают смыслы из более сложной, неструктурированной среды.
Обзор платформ для текстовой и бизнес-аналитики
В этом разделе мы подробно рассмотрим решения, которые специализируются на обработке текстовой информации, анализе корпоративного документооборота и контроле отделов продаж. Каждая платформа имеет свою специфику, целевую аудиторию и технические требования к внедрению.
MonkeyLearn
Платформа MonkeyLearn представляет собой облачное решение, ориентированное на глубокий анализ текстовой информации. Главная особенность системы заключается в предоставлении пользователям инструментов для работы с применением алгоритмов машинного обучения, не требующих глубоких знаний в области программирования. Сервис позволяет автоматизировать процессы категоризации, извлечения сущностей и анализа тональности текстов.
Функционал MonkeyLearn базируется на двух основных подходах. Во-первых, пользователи могут применять готовые (pre-trained) модели машинного обучения для решения стандартных задач. К таким задачам относится базовая классификация обращений, определение эмоциональной окраски отзывов (позитивная, негативная, нейтральная) или извлечение ключевых слов из массивов текста. Во-вторых, платформа предоставляет возможности для создания и настройки кастомных моделей. Если специфика бизнеса требует уникальной логики обработки, пользователь может загрузить собственный набор обучающей информации (например, исторические данные из helpdesk-системы) и натренировать алгоритм под конкретные критерии тегирования.
Интерфейс системы визуально ориентирован, что упрощает процесс разметки данных при обучении собственных моделей. Пользователь вручную присваивает теги примерам текстов, а система итеративно подстраивает веса алгоритма для повышения точности предсказаний на новых данных. Интеграционные возможности предполагают использование API для подключения аналитического движка к сторонним приложениям, CRM-системам или базам данных.
Что касается коммерческих условий использования MonkeyLearn, актуальные тарифы указаны на официальной странице Pricing, однако доступная публичная информация не содержит конкретных цен в цифрах. Наличие или отсутствие бесплатного тарифа также не раскрывается в открытых источниках, поэтому для получения точных цифр уточняйте на сайте сервиса. Информацию о возможности прямого доступа с территории РФ и методах оплаты картами российских банков также следует уточнять на сайте.
Преферентум
Преферентум — это специализированное решение для интеллектуальной обработки и глубокого анализа неструктурированных текстовых массивов, созданное для нужд текстовой аналитики и оптимизации электронного документооборота (ЭДО). Платформа ориентирована преимущественно на средний и крупный бизнес, где объемы входящей и исходящей документации требуют автоматизации на уровне понимания естественного языка.
Ядро системы направлено на извлечение значимых фактов, реквизитов и сущностей из сплошного текста. В корпоративной практике часто встречаются ситуации, когда договор или техническое задание представляет собой многостраничный документ в формате PDF или DOCX без строгой структуры полей. Преферентум способен анализировать такие документы, автоматически классифицировать их по типам (договор подряда, счет-фактура, акт приема-передачи), находить стороны сделки, суммы, сроки действия и штрафные санкции. Эта информация затем структурируется и передается в корпоративные системы учета, минимизируя ручной труд делопроизводителей и юристов.
Важной сферой применения Преферентум является семантический поиск по корпоративным базам знаний. Система понимает синонимы, контекст и морфологию языка, что позволяет находить нужные фрагменты документов даже при неточном совпадении поискового запроса с оригинальным текстом. Это критически важно для юридических департаментов и служб безопасности при проведении внутренних расследований или аудите договорной базы.
Финансовая модель использования сервиса ориентирована на корпоративный сегмент. Стоимость продуктов Преферентум начинается от 100 000 ₽, при этом окончательные условия и итоговая цена рассчитываются индивидуально в зависимости от масштаба задач клиента, объемов обрабатываемой документации и сложности внедрения. Информацию о наличии бесплатного тестового тарифа уточняйте на сайте сервиса. Сама платформа открывается без обходных путей из России, однако вопросы, связанные с конкретными способами оплаты, уточняйте на сайте.
bewise.ai
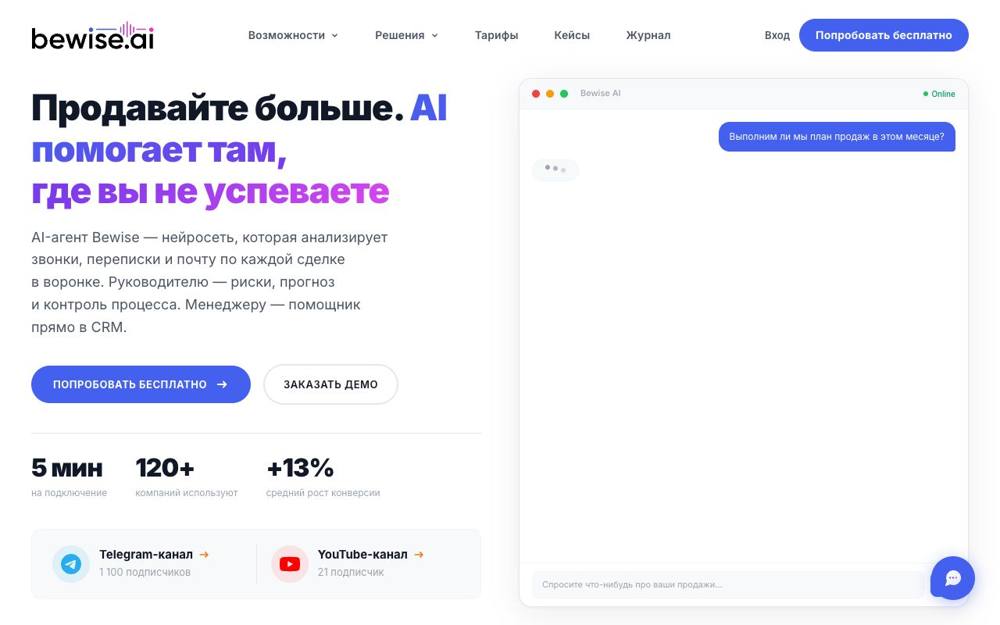
Сервис bewise.ai позиционируется как комплексный AI-агент, разработанный специально для анализа и тотального контроля процессов продаж, а также глубокой интеграции с CRM-системами, записями звонков и текстовой перепиской. Инструмент решает одну из главных болей коммерческих директоров — проблему слепых зон в коммуникации менеджеров с клиентами.
Платформа работает по принципу интеллектуального ассистента, который автоматически обрабатывает все каналы коммуникации. Аудиозаписи телефонных разговоров транскрибируются (переводятся в текст), после чего алгоритм анализирует диалог по заданным чек-листам. Система способна распознавать, поздоровался ли менеджер по регламенту, выявил ли потребности клиента, предложил ли дополнительные услуги (upsell/cross-sell) и как именно отработал типовые возражения («дорого», «я подумаю»). Кроме аудио, анализируется текстовая переписка в мессенджерах и электронной почте.
Результатом работы bewise.ai является не просто текст звонка, а готовая аналитика: автоматическое заполнение полей в карточке сделки CRM-системы (например, фиксация бюджета клиента, сроков принятия решения), формирование краткого резюме (саммари) разговора и выставление оценки качества работы сотрудника. Это позволяет руководителям фокусироваться на обучении отстающих менеджеров, опираясь на объективные числовые показатели, а не на выборочное прослушивание звонков.
Ценовая политика bewise.ai достаточно прозрачна. Пользователям доступен полностью бесплатный тариф со стоимостью 0 ₽ навсегда, который позволяет ознакомиться с базовыми функциями. Платные тарифы с расширенными возможностями начинаются от 19 000 ₽ в месяц при условии помесячной оплаты. Для компаний, планирующих долгосрочное использование, предусмотрены скидки до 20% при оплате подписки за год. Платформа открывается без обходных путей из России, и, что важно для локального бизнеса, российские карты принимаются к оплате без ограничений.
Решения для компьютерного зрения и распознавания документов
Вторая крупная категория инструментов связана с обработкой визуальной информации. Технологии компьютерного зрения (Computer Vision) позволяют машинам извлекать структурированные данные из пикселей. Это критически важно для мобильных приложений, систем безопасности и финтех-отрасли, где скорость и точность ввода информации напрямую влияют на пользовательский опыт и операционные расходы.
Smart Engines
Компания Smart Engines предоставляет мощный набор инструментов разработчика (SDK), специализирующийся на распознавании и извлечении информации из различных визуальных источников. Продукт сфокусирован на обработке удостоверений личности, стандартизированных документов, заполненных форм, банковских карт, а также штрихкодов и QR-кодов. Технология находит применение в банковском секторе (приложение сканирует карту для перевода), ритейле (сканирование штрихкодов курьерами) и сервисах каршеринга (быстрая проверка прав и паспорта).
Ключевым технологическим преимуществом Smart Engines является архитектура решения. Распознавание происходит непосредственно на конечном устройстве пользователя (on-device), будь то мобильный телефон, браузер (веб-интерфейс), десктопный компьютер или корпоративный сервер. Это означает, что фотографии паспортов и данные кредитных карт не отправляются в сторонние облачные сервисы, что обеспечивает высочайший уровень конфиденциальности и соответствие жестким требованиям информационной безопасности. SDK оптимизирован для работы на различных платформах и не требует постоянного подключения к интернету для выполнения процесса распознавания.
Интеграция SDK от Smart Engines позволяет разработчикам встраивать функционал сканирования прямо в интерфейс своих приложений, контролируя весь процесс взаимодействия с пользователем, включая подсказки по позиционированию документа в кадре камеры. Алгоритмы устойчивы к бликам, плохому освещению и геометрическим искажениям документа.
Коммерческая модель использования Smart Engines строится на корпоративном подходе B2B. Стоимость лицензирования рассчитывается строго индивидуально для каждого клиента. Итоговая цена зависит от множества факторов: требуемого функционала (какие именно типы документов нужно распознавать), платформ внедрения и количественных требований (ожидаемого объема транзакций или количества установок). Информацию о наличии стандартного бесплатного тарифа уточняйте на сайте сервиса, однако разработчикам доступны демо-приложения, а пробный SDK предоставляется по запросу. Информацию о доступности сайта из РФ и способах оплаты также уточняйте на сайте.
Tevian
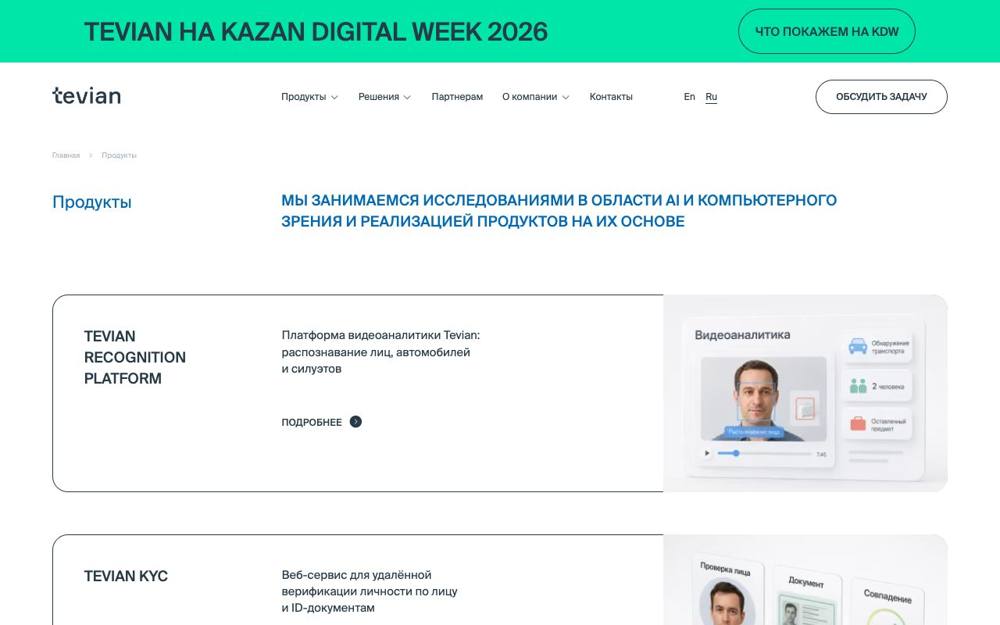
Компания Tevian фокусируется на создании и внедрении комплексных решений, базирующихся на передовых технологиях компьютерного зрения. В отличие от узкоспециализированных систем распознавания документов, спектр задач, решаемых алгоритмами Tevian, охватывает более широкие области, включая видеоаналитику, биометрическое распознавание лиц, процедуры KYC (знай своего клиента) и глубокую обработку документации.
В сфере видеоаналитики решения Tevian применяются для мониторинга видеопотоков с камер наблюдения. Алгоритмы способны детектировать присутствие людей в кадре, отслеживать их перемещения, распознавать автомобильные номера и выявлять специфические события (например, оставленные предметы или несанкционированное проникновение в зону). Это востребовано в концепциях «умного города», на промышленных предприятиях и в крупных торговых сетях для анализа паттернов поведения покупателей.
Биометрические модули Tevian обеспечивают высокую точность распознавания лиц, что активно используется в системах контроля и управления доступом (СКУД), а также при удаленной идентификации пользователей. Процесс KYC, встроенный в алгоритмы платформы, позволяет финансовым организациям проводить безопасный онбординг клиентов, сверяя лицо человека перед камерой с фотографией в предоставленном документе и проверяя живость лица (liveness detection) для защиты от атак с использованием распечатанных фотографий или экранов смартфонов.
Условия сотрудничества с Tevian предполагают проектный подход. Фиксированных цен на сайте не представлено — стоимость внедрения рассчитывается индивидуально для каждого заказчика. На итоговый бюджет влияет конфигурация проекта, тип и объем используемого оборудования, число обрабатываемых видеоканалов, набор требуемой функциональности, уровень технической поддержки и необходимость интеграции с существующими ИТ-системами заказчика. Информацию о возможности бесплатного тестирования уточняйте на сайте сервиса. Официальный ресурс компании открывается без обходных путей, однако вопросы, связанные с форматами оплаты, уточняйте на сайте.
ИИ-помощники для обучения и структурирования информации
Инструменты на базе алгоритмов машинного обучения находят применение не только в корпоративной среде, но и в образовательном секторе. Способность нейросетей анализировать массивы текста, выявлять закономерности и генерировать связные объяснения делает их отличными помощниками в усвоении сложных дисциплин.
Умка ИИ
Сервис Умка ИИ представляет собой специализированного личного ИИ-репетитора, созданного для помощи учащимся в освоении образовательных программ. Платформа ориентирована на решение широкого спектра задач: от помощи в выполнении повседневных школьных и вузовских заданий до целенаправленной подготовки к государственным экзаменам — ЕГЭ и ОГЭ.
Принцип работы Умка ИИ базируется на диалоговом интерфейсе, где учащийся может задать вопрос в свободной форме, загрузить условие задачи или попросить объяснить непонятную тему. Алгоритм не просто выдает готовый ответ, а стремится выстроить процесс объяснения, предоставляя пошаговые решения математических уравнений, разборы физических законов или анализ литературных произведений. Система помогает структурировать информацию при написании эссе, рефератов или курсовых работ, выступая в роли интеллектуального спарринг-партнера для студента.
Для пользователей, ищущих нестандартные сценарии применения генеративных моделей при работе с текстами, возможности подобных диалоговых систем могут быть расширены. Например, о том, как использовать текстовые алгоритмы для творческих задач, можно прочитать в материале Поздравление с помощью нейросети: генератор в стихах и прозе. Однако профиль Умка ИИ остается строго образовательным и аналитическим в рамках учебной программы.
Доступность платформы для широкой аудитории обеспечивается наличием базового бесплатного тарифа, в рамках которого пользователю предоставляется 5 запросов в день. Это позволяет протестировать качество ответов нейросети и оценить ее полезность для конкретных учебных дисциплин. Для снятия ограничений существует тариф PRO, однако его точная стоимость на официальном сайте не указана — актуальные цены уточняйте на сайте сервиса. Платформа открывается без обходных путей для пользователей из России, при этом методы оплаты премиум-доступа следует уточнять на сайте.
Как выбрать подходящий сервис: критерии и советы
Выбор оптимальной нейросети для работы с данными зависит от множества факторов: типа обрабатываемой информации, требований к безопасности, технической экспертизы команды и имеющегося бюджета. Ошибка на этапе выбора может привести к длительным и дорогостоящим попыткам внедрения неподходящего продукта.
Первым шагом является определение формата исходной информации. Если ваша цель — извлечение смысла из массивов неструктурированного корпоративного текста, договоров и нормативных актов, целесообразно рассматривать решения класса Преферентум или исследовать возможности MonkeyLearn для классификации. Если же бизнес-процесс завязан на контроль качества телефонных переговоров менеджеров с клиентами, специализированный агент bewise.ai справится с задачей эффективнее, чем универсальные текстовые модели, благодаря встроенным интеграциям с телефонией и CRM.
Второй критически важный критерий — архитектура развертывания и требования к безопасности. Финансовые организации, государственные структуры и медицинские учреждения часто ограничены строгими регламентами работы с персональными данными. В таких случаях передача фотографий паспортов или сканов договоров в публичные облака недопустима. Решения в формате SDK, такие как Smart Engines, обрабатывающие кадры локально на устройстве пользователя, становятся единственным легитимным вариантом. Для задач видеоаналитики и KYC, требующих сложного аппаратного обеспечения, проектный подход Tevian позволит выстроить безопасную инфраструктуру на стороне заказчика. Для образовательных целей (Умка ИИ) или маркетинговой аналитики облачный формат вполне приемлем и удобен.
Третий аспект — модель ценообразования. Малому бизнесу и индивидуальным пользователям стоит обращать внимание на сервисы с прозрачными тарифами по подписке (SaaS) или наличием бесплатных лимитов (как 0 ₽ навсегда у bewise.ai или 5 запросов в день у Умка ИИ). Крупные внедрения, связанные с распознаванием лиц, видеоаналитикой (Tevian) или глубоким анализом ЭДО (Преферентум, от 100 000 ₽), требуют закладывать бюджеты на индивидуальную разработку, настройку оборудования и интеграционные работы, стоимость которых рассчитывается под конкретный проект.
Типичные ошибки при внедрении ИИ-аналитики
Процесс интеграции интеллектуальных инструментов в устоявшиеся процессы часто сопровождается завышенными ожиданиями и техническими просчетами. Разберем наиболее распространенные ошибки, которые допускают компании и индивидуальные пользователи.
Игнорирование качества входящего материала — главная причина неудач. В машинном обучении действует железное правило: «мусор на входе — мусор на выходе» (Garbage in, garbage out). Если вы пытаетесь обучить кастомную модель в MonkeyLearn на несбалансированной или некорректно размеченной выборке текстов, алгоритм усвоит эти ошибки и будет выдавать неверные классификации. Точно так же, если камера смартфона загрязнена или условия освещения при сканировании документа через SDK критически плохие, даже мощные алгоритмы Smart Engines могут столкнуться с трудностями. Подготовка и очистка массивов перед подачей в алгоритм — обязательный этап.
Вторая ошибка — ожидание полной автономности от системы. Интеллектуальный агент bewise.ai отлично справляется с транскрибацией и скорингом звонков, но он не может заменить руководителя отдела продаж в вопросах мотивации сотрудников и принятия стратегических кадровых решений. ИИ должен восприниматься как мощный ассистент, снимающий рутину, а не как самостоятельный субъект принятия критических бизнес-решений.
Третья проблема кроется в отсутствии визуализации и понятных интерфейсов для конечных пользователей. Получить массив классифицированных тегов или извлеченных сущностей недостаточно — бизнес-пользователям нужны наглядные дашборды. О том, как превращать сухие массивы в понятные графики, можно узнать в статье Как создать инфографику с помощью нейросети: сервисы и шаблоны.
Пошаговый сценарий обработки информации с помощью ИИ
Для того чтобы абстрактные технологии приносили реальную пользу, процесс работы с ними необходимо структурировать. Ниже представлен универсальный пошаговый сценарий, который можно адаптировать под большинство платформ, будь то текстовая аналитика или распознавание документов.
Шаг 1: Формулировка задачи и выбор метрик. Четко определите, что именно вы хотите получить на выходе. Например, задача — сократить время оформления клиента в банке. Метрика успеха — уменьшение времени ввода паспортных данных с 3 минут до 10 секунд.
Шаг 2: Выбор инструмента интеграции. Исходя из задачи, выбирается платформа. Для описанного примера подойдет внедрение SDK от Smart Engines в мобильное приложение банка. Для задачи контроля скриптов в CRM потребуется подключение сервиса bewise.ai.
Шаг 3: Настройка и обучение (при необходимости). Если используется система с готовыми моделями (Умка ИИ, распознавание стандартных паспортов в Tevian), этот шаг сводится к базовой настройке API. Если задача специфическая (например, классификация узкоспециализированных технических рекламаций в MonkeyLearn), потребуется загрузить историческую базу документов и вручную разметить несколько сотен примеров, чтобы алгоритм понял логику тегирования.
Шаг 4: Тестовый прогон на ограниченной выборке (Пилот). Никогда не запускайте автоматизацию сразу на всем объеме. Пропустите через Преферентум тестовую сотню договоров, проанализируйте, корректно ли извлекаются суммы и даты. Проверьте, насколько точно транскрибируются звонки с плохим качеством звука. На этом этапе выявляются краевые случаи (edge cases) и корректируются настройки.
Шаг 5: Интеграция в бизнес-процесс и мониторинг. Настроенный алгоритм подключается к корпоративной шине. Данные начинают поступать в автоматическом режиме. Важно назначить ответственного сотрудника, который будет периодически проводить выборочный контроль качества работы нейросети, чтобы вовремя заметить деградацию модели или изменение формата входящих документов.
FAQ: частые вопросы
Требуется ли навык программирования для работы с этими сервисами?
Зависит от выбранного продукта. Для использования образовательного помощника Умка ИИ навыки программирования не нужны — взаимодействие происходит через простой чат-интерфейс. Платформа bewise.ai также предлагает готовый интерфейс для руководителей отделов продаж. Инструменты вроде MonkeyLearn позиционируются как low-code решения с визуальным интерфейсом, но для их полноценной интеграции в ваши системы потребуется настройка API. А вот продукты Smart Engines и Tevian предоставляются в виде SDK и API, что требует привлечения квалифицированных разработчиков для внедрения кода в ваши приложения или инфраструктуру.
Безопасно ли передавать корпоративную документацию в нейросети?
Вопрос безопасности зависит от архитектуры решения. Облачные сервисы всегда подразумевают передачу информации на внешние серверы, что может противоречить строгим NDA некоторых корпораций (в таких случаях использование публичных API недопустимо). Однако решения, работающие по принципу on-device (как SDK от Smart Engines) или разворачиваемые локально в контуре заказчика (on-premise решения, которые часто предлагают разработчики enterprise-уровня, такие как Преферентум или Tevian в рамках индивидуальных проектов), обеспечивают максимальную безопасность, так как информация не покидает пределы вашего устройства или корпоративного сервера.
Можно ли использовать эти инструменты полностью бесплатно?
Из рассмотренных платформ прозрачная бесплатная модель подтверждена для сервиса bewise.ai (тариф 0 ₽ навсегда для базовых задач) и образовательного сервиса Умка ИИ (5 бесплатных запросов в день). Для остальных продуктов (MonkeyLearn, Smart Engines, Преферентум, Tevian) информацию о наличии бесплатных тарифов или тестовых сред необходимо уточнять на официальных сайтах, так как они ориентированы на корпоративный сектор (B2B), где чаще практикуется предоставление временных демо-версий по запросу после общения с отделом продаж.
Как интегрировать распознавание документов в свое мобильное приложение?
Для мобильной интеграции используются специализированные наборы библиотек (SDK). Например, получив лицензию и пакет разработчика от Smart Engines, ваши программисты встраивают предоставленный код в iOS- или Android-приложение. SDK включает в себя не только саму математику нейросети, но и элементы пользовательского интерфейса (UI) — рамки для наведения камеры, алгоритмы захвата лучшего кадра и управления вспышкой. Весь процесс распознавания происходит внутри процессора смартфона в режиме реального времени.
Что делать, если алгоритм ошибается при анализе звонков в отделе продаж?
Любая нейросеть для работы с данными имеет определенную погрешность (допустимый процент ошибок). При использовании платформ контроля качества, таких как bewise.ai, рекомендуется внедрять подход «Human-in-the-loop» (человек в цикле). Система автоматически размечает 100% звонков, выявляет критические нарушения или отклонения от скрипта, а руководитель или асессор выборочно прослушивает только спорные диалоги. Если система систематически ошибается на специфических профессиональных терминах, алгоритмы речевой аналитики обычно позволяют добавлять словари терминов для повышения точности транскрибации.
Заменяют ли ИИ-решения живых аналитиков и делопроизводителей?
На текущем этапе развития технологий инструменты вроде Преферентум или MonkeyLearn не заменяют специалистов полностью, а выступают в роли мощных «экзоскелетов», многократно повышающих их производительность. ИИ берет на себя рутинную, потоковую работу: первичное извлечение реквизитов, маршрутизацию обращений, сортировку договоров. Это позволяет живым аналитикам, юристам и делопроизводителям сфокусироваться на принятии сложных решений, разрешении нестандартных коллизий и стратегическом планировании, где требуется человеческая эмпатия и широкий контекст, недоступный алгоритмам.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.