Как улучшить качество песни нейросетью: сервисы для очистки звука и мастеринга
Узнайте, как улучшить качество песни с помощью нейросетей. Подробный обзор сервисов для мастеринга, разделения треков, транскрибации и работы со звуком.
Содержание статьи11
- Архитектура звука и возможности искусственного интеллекта
- Обзор сервисов для работы с аудио и музыкой
- Как выбрать подходящий инструмент для ваших задач
- Пошаговый сценарий обработки и улучшения трека
- Типичные ошибки при использовании аудио-нейросетей
- Сценарии применения: от музыкантов до стримеров
- Промпты и параметры: как правильно ставить задачи нейросетям
- Экосистема музыкального продакшена и управление проектами
- Реставрация аудиоархивов и борьба с артефактами
- Будущее музыкального продакшена и искусственного интеллекта
- FAQ: частые вопросы
Многие авторы, продюсеры и контент-мейкеры ищут эффективные способы, как улучшить качество песни с помощью нейросети, чтобы добиться профессионального, чистого и плотного студийного звучания даже в домашних условиях без использования дорогостоящего аналогового оборудования. Современные алгоритмы машинного обучения способны анализировать аудиосигнал на микроуровне, устраняя фоновые шумы, выравнивая частотный баланс, разделяя монолитную аудиодорожку на отдельные инструменты и даже генерируя новые музыкальные идеи с нуля. На рынке существует множество специализированных платформ, таких как TuneFlow для комплексного управления студийными проектами или AI Song для генерации новых композиций.
Спектр задач, которые решают алгоритмы, огромен: от выделения ударных партий с помощью Drumless и конвертации аудио в ноты через AnthemScore by Lunaverus, до создания субтитров и транскрибации медиафайлов в RecCloud, а также изменения голоса в реальном времени с iMyFone MagicMic. В этом руководстве мы детально разберем, какие платформы лучше всего подходят для конкретных сценариев работы со звуком, какие ограничения существуют на бесплатных тарифах, и как правильно интегрировать эти инструменты в ваш ежедневный творческий процесс для достижения максимального результата.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| Drumless | Удаление барабанов, разделение трека на партию ударных и остальную музыку | От $2.99 в месяц | Есть (ограничение до 10 МБ) | Уточняйте на сайте сервиса |
| TuneFlow | Управление библиотекой, версиями, проектами, ревью, AI-инструменты студии | От $15 в месяц (без НДС) | Есть (14-дневный пробный период) | Уточняйте на сайте сервиса |
| AI Song | Онлайн-генерация музыки и песен с помощью алгоритмов | От $8 в месяц (при годовой оплате) | Есть (с разовой квотой) | Уточняйте на сайте сервиса |
| AnthemScore by Lunaverus | Преобразование аудио и MIDI в нотные партитуры (PDF, MusicXML, MIDI) | От $8.33 в месяц (при годовой оплате) или от $29 (разово за десктоп) | Есть (бесплатный план) | Уточняйте на сайте сервиса |
| RecCloud | Расшифровка, субтитры, перевод, озвучивание, генерация и монтаж видео | От ~$4 в месяц (при годовой оплате) | Есть (бесплатный доступ и пробные функции) | Уточняйте на сайте сервиса |
| iMyFone MagicMic | Изменение голоса в реальном времени, AI-фильтры, эффекты для стримов и игр | От $9.99 в месяц | Есть | Уточняйте на сайте сервиса |
Архитектура звука и возможности искусственного интеллекта
Цифровая обработка звука прошла огромный путь от простых эквалайзеров и компрессоров до сложных многоуровневых нейронных сетей, способных понимать контекст аудиозаписи. Традиционные методы очистки звука или мастеринга полагались на жестко заданные математические алгоритмы. Например, чтобы удалить шум, нужно было выделить образец этого шума, и программа пыталась вычесть эти частоты из всего трека. Это часто приводило к эффекту «звучания из трубы», так как вместе с шумом вырезались полезные гармоники человеческого голоса или музыкального инструмента.
Сегодня нейросети обучаются на миллионах часов аудиоданных. Они понимают, как звучит чистый голос, как резонирует малый барабан, как ведет себя бас-гитара в разных жанрах. Когда вы загружаете трек в современный сервис, алгоритм не просто режет частоты — он воссоздает поврежденные участки спектра, предсказывая, какими они должны быть в идеальных условиях. Это позволяет проводить так называемое спектральное восстановление. Кроме того, появилась возможность качественного «стемпинга» (stem separation) — разделения сведенного (mastered) трека обратно на мультитрек, что долгое время считалось физически невозможным процессом, сравнимым с попыткой разделить испеченный торт обратно на муку, яйца и сахар.
Алгоритмы машинного обучения также революционизировали процесс мастеринга. Вместо того чтобы вручную настраивать цепочку из эквалайзера, сатуратора, многополосного компрессора и лимитера, система анализирует динамический диапазон и частотную характеристику вашей композиции, сравнивает ее с эталонными коммерческими треками в выбранном жанре и применяет необходимую обработку. Это делает звук громким, плотным и готовым к загрузке на стриминговые платформы без потери транзиентов и появления искажений.
Обзор сервисов для работы с аудио и музыкой
Ниже представлен подробный разбор платформ, которые помогут решить самые разные задачи: от изоляции конкретных инструментов и конвертации аудио в ноты до комплексного управления проектами и генерации музыки.
Drumless
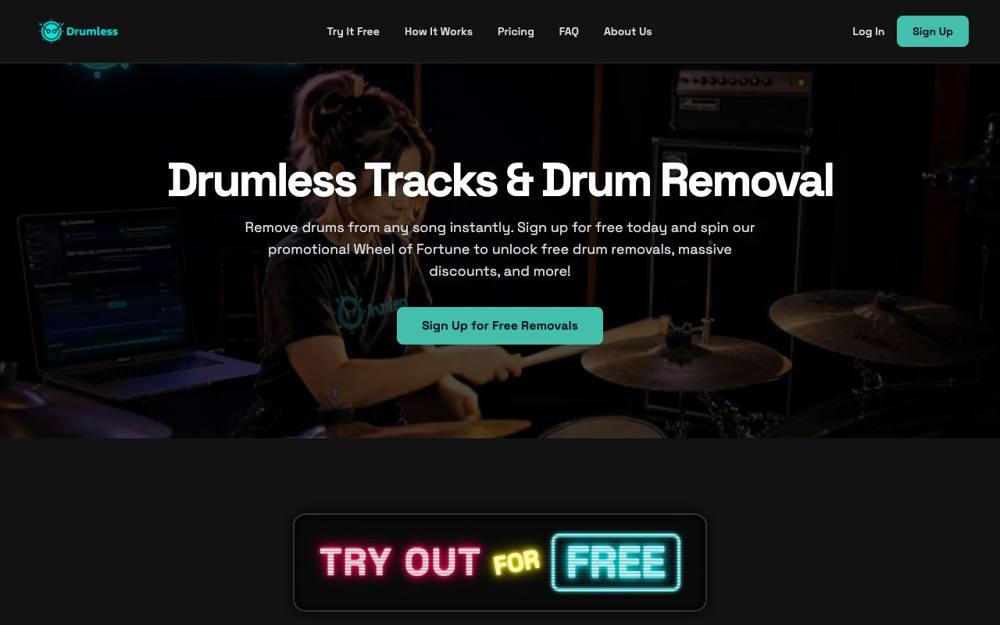
Инструмент узкой направленности, который решает одну из самых востребованных задач среди битмейкеров, диджеев и музыкальных продюсеров. Платформа удаляет барабанную партию из файлов форматов MP3 или WAV, разделяя трек на чистые барабаны и остальную музыкальную составляющую (вокал, бас, синтезаторы, гитары). Это критически важно для создания ремиксов, мэшапов, а также для музыкантов, которые хотят практиковаться в игре на барабанах поверх любимых композиций без конфликта с оригинальным битом.
Сервис предоставляет бесплатную пробу с ограничением размера загружаемого файла до 10 МБ, что вполне достаточно для обработки коротких сэмплов или лупов. Для полноценной работы с полными песнями предусмотрен Premium-тариф: $0.99 за первый месяц, а затем $2.99 в месяц или $14.90 в год. Условия доступа и возможности оплаты картами из РФ необходимо уточнять на сайте сервиса.
TuneFlow
Платформа, представляющая собой не просто отдельный эффект, а целую экосистему для музыкального продакшена. TuneFlow объединяет рабочее пространство студии, позволяя централизованно управлять музыкальной библиотекой, отслеживать версии проектов, решать вопросы лицензирования и авторских прав. Особенно полезна функция аудио- и видеоревью, которая упрощает коммуникацию с клиентами и соавторами, позволяя оставлять таймкод-комментарии прямо на волновой форме (waveform). Также система интегрирует различные AI-инструменты для работы со звуком.
Для ознакомления с функционалом предоставляется 14-дневный бесплатный пробный период. Платные тарифы начинаются с плана Small за $15 в месяц. Для более требовательных пользователей есть тариф Pro за $39 в месяц, а для крупных студий — Business за $99 в месяц (все цены указаны без учета НДС). Информация о доступе и методах оплаты из РФ на данный момент неизвестна — уточняйте на сайте.
AI Song
Этот сервис сфокусирован на креативной стороне процесса. AI Song генерирует музыку и полноценные песни с помощью ИИ прямо в браузере. Это отличное решение для создателей контента, которым нужен уникальный фоновый трек без риска получить страйк за нарушение авторских прав, а также для авторов текстов, ищущих музыкальное вдохновение и желающих услышать, как их стихи могут звучать в формате готовой песни различных жанров.
Пользователям доступен бесплатный тариф, который включает разовую квоту на генерацию, позволяющую протестировать качество алгоритмов. Если требуется регулярное создание контента, платные планы начинаются от $8 в месяц при условии годовой оплаты. Возможность работы из России и способы оплаты подписки следует уточнять на сайте сервиса.
AnthemScore by Lunaverus
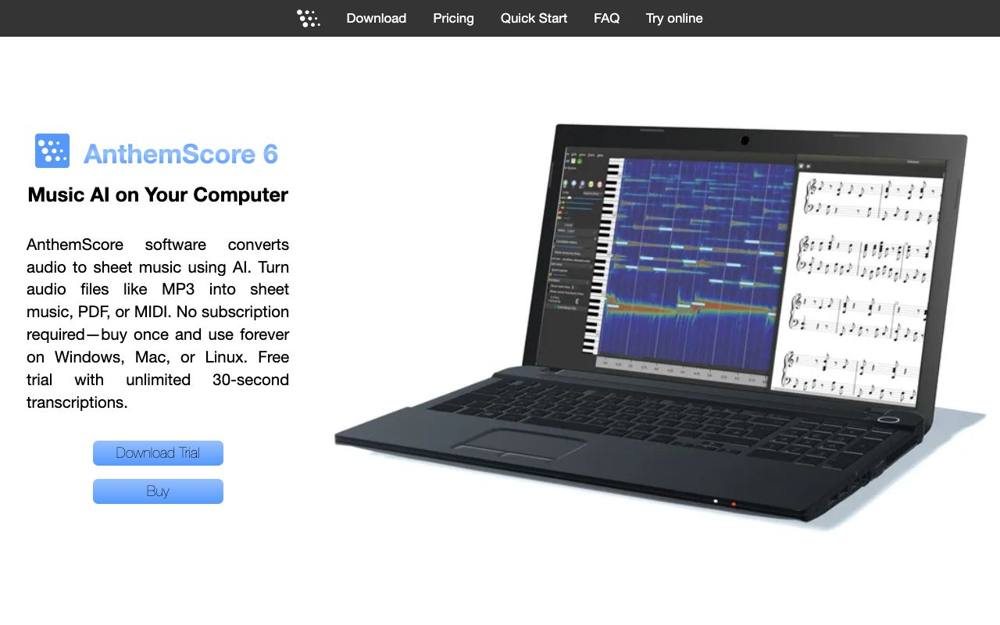
Мощный инструмент для композиторов, аранжировщиков и студентов музыкальных учебных заведений. Программа преобразует аудиофайлы или MIDI-данные в полноценные нотные партитуры с помощью ИИ. Распознанный материал можно экспортировать в популярные форматы PDF для печати, MusicXML для дальнейшего редактирования в нотных редакторах (таких как Sibelius, Finale или MuseScore) и MIDI для работы в секвенсорах (DAW). Алгоритм анализирует полифоническое аудио и визуализирует спектрограмму поверх сгенерированных нот, что позволяет вручную корректировать сложные участки.
Доступен бесплатный план для базовых задач. Подписка Plus обойдется в $8.33 в месяц (при ежегодной оплате), а версия Pro — в $24.99 в месяц (при ежегодной оплате). Для тех, кто предпочитает stand-alone решения, существуют десктопные версии в виде разовой покупки стоимостью от $29. Статус работы сервиса в РФ и доступные методы оплаты необходимо уточнять на официальном сайте.
RecCloud
Универсальный медиа-комбайн, который выходит за рамки чисто музыкального продакшена и охватывает потребности создателей видеоконтента, подкастеров и журналистов. Сервис предоставляет ИИ-инструменты для автоматической расшифровки аудио, создания точных субтитров, перевода на другие языки и озвучивания (text-to-speech) аудио и видео. Кроме того, платформа включает функции для генерации видео и редактирования контента, что делает ее удобной для создания коротких роликов для социальных сетей из длинных аудиозаписей.
Сервис предлагает бесплатный доступ и пробные функции для оценки возможностей платформы. Платные тарифы начинаются примерно от $4 в месяц при условии годовой оплаты. Для краткосрочных проектов доступны недельные тарифы, а для корпоративных клиентов — специализированные бизнес-планы. Оплата из РФ и доступность сервиса — уточняйте на сайте.
iMyFone MagicMic
Инструмент, ориентированный на геймеров, стримеров, пранкеров и создателей развлекательного контента. Программа изменяет голос в реальном времени с помощью продвинутых AI-фильтров. В отличие от старых питч-шифтеров, которые просто понижали или повышали тон, делая голос похожим на робота или бурундука, нейросети анализируют тембр и полностью преобразуют его, сохраняя естественные интонации. В библиотеке также представлены различные звуковые эффекты для использования в играх, голосовых чатах (Discord, TeamSpeak) и на стриминговых платформах.
Программа имеет бесплатную версию с базовым набором голосов. Платная версия, открывающая полный доступ к библиотеке фильтров и эффектов, стоит от $9.99 в месяц. Разработчики также предлагают годовой и пожизненный планы для экономии в долгосрочной перспективе. Актуальную информацию о работе в РФ и способах оплаты уточняйте на сайте сервиса.
Как выбрать подходящий инструмент для ваших задач
Выбор правильного нейросетевого сервиса зависит от конечной цели, вашего уровня подготовки и формата исходных файлов. Чтобы не тратить время и деньги на функционал, который вам не пригодится, важно классифицировать свои потребности. Рассмотрим несколько типичных профилей пользователей и оптимальные решения для них.
Для музыкальных продюсеров и диджеев: Если ваша главная цель — создание ремиксов, сэмплирование или анализ структуры коммерческих треков, вам необходимы инструменты изоляции. Удаление барабанов и получение чистой акапеллы или мелодии — основа диджеинга. Здесь идеально впишется Drumless для работы с битом. А если вам нужно полностью избавиться от голоса в треке, чтобы написать собственную аранжировку, рекомендуем изучить профильные инструменты. Подробнее об этом можно прочитать в нашей статье Убрать вокал из песни нейросетью: минусовка онлайн.
Для композиторов и преподавателей музыки: Транскрипция на слух сложных джазовых соло или оркестровых произведений может занимать десятки часов. В этом случае незаменимым помощником станет AnthemScore by Lunaverus. Возможность получить готовый MusicXML-файл из старой MP3-записи кардинально ускоряет процесс написания партитур, подготовки учебных материалов и создания кавер-версий.
Для стримеров и подкастеров: Контент-мейкерам, работающим в прямом эфире, важна минимальная задержка (latency) и стабильность. Для создания интерактивного шоу с изменением персонажей отлично подойдет iMyFone MagicMic. А если вы записываете длинные разговорные видео или подкасты и вам нужно быстро нарезать шортсы, сгенерировать субтитры и перевести их на английский язык, чтобы расширить аудиторию, стоит обратить внимание на RecCloud.
Для студий звукозаписи и менеджеров артистов: Когда дело доходит до управления множеством версий миксов, сбора фидбека от вокалистов, гитаристов и продюсеров, обычные облачные диски становятся неудобными. TuneFlow предлагает специализированное рабочее пространство, где комментарии привязаны к конкретным секундам трека, что исключает недопонимание в духе «сделай бас тише где-то на второй минуте».
Для инди-разработчиков игр и видеомейкеров: Часто для фонового оформления проекта нужна музыка определенного настроения, но бюджета на лицензирование коммерческих треков или наем композитора нет. В таких ситуациях использование AI Song позволяет быстро сгенерировать нужный саундтрек, задав жанр, темп и атмосферу, избежав при этом проблем с авторскими правами на YouTube или Twitch.
Пошаговый сценарий обработки и улучшения трека
Работа со звуком требует методичного подхода. Даже самые продвинутые нейросети могут выдать артефакты, если скормить им неправильно подготовленный материал. Рассмотрим универсальный алгоритм работы по очистке и улучшению композиции.
Шаг 1: Аудит и подготовка исходника. Перед загрузкой файла в облачный сервис убедитесь, что он имеет максимально возможное качество. Если у вас есть WAV или FLAC — используйте их. MP3 с битрейтом 128 kbps уже содержит артефакты сжатия (обрезанные высокие частоты, искажения фазы), которые нейросеть может ошибочно принять за полезный сигнал или, наоборот, усилить. Обрежьте пустую тишину в начале и конце трека в любом бесплатном редакторе, чтобы не тратить лимиты сервисов (например, 10 МБ в бесплатном тарифе Drumless).
Шаг 2: Разделение на стемы (Stem Separation). Если трек требует глубокой проработки, его нужно разделить. Загрузите файл в платформу для сепарации. Выделите вокал, ударные, бас и остальные инструменты. Сохраните каждый стем в отдельный WAV-файл. На этом этапе вы можете обнаружить, что вокал конфликтует с частотами синтезатора, или бас звучит слишком гулко.
Шаг 3: Очистка и реставрация. Проанализируйте полученные дорожки. Если в вокальной партии остался шум помещения (реверберация комнаты) или щелчки, пропустите именно этот стем через инструменты шумоподавления и де-реверберации. Нейросети отлично справляются с удалением эха, оставляя сухой (dry) голос, который затем можно обработать студийными эффектами.
Шаг 4: Сборка и мастеринг. Загрузите очищенные стемы обратно в вашу DAW или рабочее пространство (например, TuneFlow). Выстройте баланс громкости заново. Теперь, когда инструменты не конфликтуют и очищены от грязи, финальный микс будет звучать гораздо прозрачнее. Затем примените AI-мастеринг к мастер-шине, чтобы поднять общую громкость до индустриальных стандартов (обычно около -14 LUFS для стримингов) и склеить элементы воедино.
Типичные ошибки при использовании аудио-нейросетей
Несмотря на кажущуюся простоту «одной кнопки», пользователи часто сталкиваются с неудовлетворительными результатами из-за непонимания принципов работы алгоритмов. Вот основные ловушки, которых следует избегать.
Во-первых, чрезмерная обработка (Over-processing). Когда вы используете шумоподавление, нейросеть вырезает частоты. Если выкрутить алгоритм на 100%, голос потеряет верхние гармоники, станет глухим и «синтетическим». Правильный подход — использовать эффект на 60-70%, оставляя легкий естественный фон, который в финальном миксе всё равно будет замаскирован музыкой.
Во-вторых, игнорирование фазовых искажений при стем-сепарации. Когда нейросеть, например Drumless, вычитает барабаны из общего микса, на оставшейся дорожке музыки могут появиться булькающие звуки (артефакты). Если вы просто сложите эти две дорожки обратно без изменений, они не всегда зазвучат как оригинальный трек из-за сдвига фаз. Поэтому стем-сепарацию лучше использовать для извлечения конкретного элемента, а не для тонкой эквализации целого микса.
В-третьих, загрузка сильно компрессированного материала. Если исходный трек уже прошел жесткий лимитинг (звучит как кирпич на волновой форме), алгоритмам машинного обучения очень сложно вычленить транзиенты (пиковые всплески звука, например, удары бочки) для создания нотных партитур в AnthemScore или для разделения инструментов. По возможности ищите несведенные версии или треки с широким динамическим диапазоном.
Наконец, неправильные ожидания от AI-генераторов. Инструменты вроде AI Song создают отличные демо-записи и фоновую музыку. Однако ожидать от них сложной, многочастной симфонии с глубоким драматургическим развитием пока рано. Генеративная музыка требует точных текстовых промптов (описаний), управления темпом и структурой (куплет-припев-бридж) через теги.
Сценарии применения: от музыкантов до стримеров
Интеграция нейросетей в повседневный рабочий процесс радикально экономит время и открывает новые творческие горизонты в разных сферах медиапроизводства.
Для создания видеоэссе или документальных фильмов часто используются архивные аудиозаписи интервью. Зачастую они записаны на старые диктофоны в гулких помещениях с уличным шумом на фоне. Пропустив такую запись через AI-инструменты очистки, режиссер получает кристально чистый голос диктора. Затем этот аудиофайл загружается в RecCloud, который автоматически генерирует таймкоды и субтитры. Это избавляет команду от рутинной работы по ручной расшифровке многочасовых интервью.
Кавер-бэнды и ресторанные музыканты постоянно сталкиваются с необходимостью быстро разучить новую песню, которую заказал клиент. Вместо того чтобы часами подбирать аккорды и соло на слух, гитарист загружает MP3-файл в AnthemScore by Lunaverus и через несколько минут получает готовую партитуру в формате PDF, где расписаны все полифонические партии, включая аккорды и мелодическую линию. Это позволяет провести репетицию и качественно выступить с новым, только что разобранным материалом в тот же вечер, не тратя дни на рутинную расшифровку нот. Экспорт в MusicXML дополнительно дает возможность транспонировать композицию в другую тональность, если оригинальная тональность не подходит вокалисту.
Для битмейкеров и продюсеров электронной музыки, работающих в жанрах хип-хоп, лоу-фай или драм-н-бейс, критически важным этапом является поиск и подготовка уникальных сэмплов. Часто продюсер находит идеальный джазовый проигрыш на старой пластинке, но оригинальные барабаны конфликтуют с современным битом, который он хочет наложить сверху. В прошлом приходилось виртуозно работать с эквалайзером, пытаясь вырезать низкие частоты бочки и высокие частоты тарелок, что неизбежно портило звучание самого сэмпла. Сегодня, используя платформу Drumless, продюсер загружает фрагмент, система удаляет барабанную партию из аудио, и на выходе получается чистый мелодический луп. Учитывая, что бесплатная проба имеет ограничение в 10 МБ, этого объема как раз хватает для обработки стандартных 4- или 8-тактовых лупов. А для полноформатной работы с целыми треками подписка Premium (от $0.99 за первый месяц, затем $2.99 в месяц или $14.90 в год) окупает себя уже на первом коммерческом заказе.
Стримеры, витуберы (VTubers) и создатели ролевого контента (например, игроки на RP-серверах GTA V) используют нейросети для глубокого погружения в образ. Программа iMyFone MagicMic позволяет изменять голос в реальном времени с помощью AI-фильтров. Если стример отыгрывает роль орка, киборга или аниме-персонажа, обычного изменения высоты тона недостаточно — алгоритмы полностью перестраивают форманты и тембральный окрас речи. Библиотека звуковых эффектов для чатов и стримов делает трансляции более интерактивными. Платная версия, стоимость которой начинается от $9.99 в месяц, открывает полный доступ ко всем профессиональным фильтрам без временных ограничений, что является стандартом для монетизируемого стриминга.
Авторы подкастов и YouTube-каналов, где важна информационная составляющая, сталкиваются с необходимостью адаптации контента для разных платформ. Записав часовой разговорный подкаст, автор загружает его в RecCloud. Сервис предоставляет ИИ-инструменты для автоматической расшифровки аудио в текст, генерации точных субтитров и даже перевода на иностранные языки. Более того, функция озвучивания позволяет создать дублированную версию ролика без привлечения профессиональных дикторов. Платные тарифы, начинающиеся примерно от $4 в месяц при годовой оплате, делают эту платформу мощным инструментом локализации и масштабирования контента.
Стоит отметить, что работа с архивными аудиозаписями часто идет рука об руку с реставрацией визуальных материалов. Если вы готовите к переизданию старую демо-запись вашей группы или оцифровываете редкий винил, вам почти наверняка потребуется восстановить выцветшую или поврежденную обложку альбома. О том, как вернуть цифровой вид старым изображениям, мы подробно рассказываем в руководстве Улучшить качество фото и реставрация старых снимков нейросетью. Использование комплексного подхода (аудио плюс визуал) значительно повышает ценность итогового продукта для слушателей и коллекционеров.
Промпты и параметры: как правильно ставить задачи нейросетям
В отличие от традиционных плагинов, где вы оперируете физическими понятиями (герцы, децибелы, миллисекунды), взаимодействие с нейросетевыми генераторами и умными обработчиками часто строится на текстовых запросах (промптах) или выборе контекстных стилей. Понимание того, как алгоритм интерпретирует ваши команды, напрямую влияет на качество итоговой песни или сэмпла.
При работе с генеративными сервисами, такими как AI Song, который создает музыку и песни с помощью ИИ онлайн, пользователи часто совершают ошибку, формулируя слишком короткие или абстрактные запросы. Промпт вроде «напиши крутую песню про любовь» даст непредсказуемый и, скорее всего, шаблонный результат. Для того чтобы сгенерированная композиция звучала профессионально и соответствовала вашей задумке, запрос должен включать несколько обязательных элементов: жанр, темп, используемые инструменты, настроение, характеристику вокала и структуру. Платные планы этого сервиса, доступные от $8 в месяц при годовой оплате, позволяют генерировать большое количество вариантов, но правильный промпт экономит ваше время.
Пример плохого промпта: Быстрая электронная музыка для пробежки.
Пример хорошего промпта для генерации: Энергичный Synthwave трек в темпе 130 BPM. Глубокий аналоговый бас, арпеджиаторы на синтезаторах в стиле 80-х, плотная прямая бочка (four-on-the-floor). Настроение: мотивирующее, футуристичное. Женский вокал с легким эффектом реверберации и эха поет о преодолении препятствий. Структура: атмосферное вступление, куплет, мощный припев с широким стерео-звучанием, инструментальное соло на синтезаторе, финал с затуханием (fade out).
Когда вы ставите задачу алгоритмам сепарации и извлечения нот, логика немного меняется. Здесь вы работаете не с текстом, а с параметрами анализа. В программе AnthemScore by Lunaverus, которая преобразует аудиофайлы или MIDI-данные в нотные партитуры, важно правильно настроить порог чувствительности (threshold). Если оригинальная запись насыщена фоновым шумом или реверберацией, алгоритм может распознать эти отражения звука как дополнительные, очень тихие ноты, что приведет к появлению так называемых «нот-призраков» (ghost notes) на партитуре. Чтобы избежать этого, перед экспортом партитуры в PDF или MusicXML, следует визуально сверить сгенерированные ноты с тепловой картой (спектрограммой), которую сервис накладывает прямо поверх нотного стана, и вручную удалить ложные срабатывания. Бесплатный план позволяет протестировать эту механику, а для постоянной работы студенты и композиторы выбирают тариф Plus ($8.33 в месяц при ежегодной оплате) или разовую покупку десктопной версии (от $29).
Экосистема музыкального продакшена и управление проектами
По мере усложнения музыкальных проектов, когда в треке задействованы десятки дорожек, сэмплов, несколько вариантов сведения и мастеринга, на первый план выходит вопрос организации студийного рабочего процесса. Традиционный подход, при котором музыканты пересылают друг другу файлы через облачные диски и мессенджеры, неизбежно приводит к хаосу. Появляются файлы с названиями вроде «Трэк_ФИНАЛ_версия4_точно_финал_мастер.wav», и найти нужную итерацию становится невозможно. Кроме того, сбор обратной связи по конкретным секундам аудио требует постоянного выписывания таймкодов.
Для решения этих административных и технических задач существуют платформы вроде TuneFlow. Этот сервис объединяет рабочее пространство студии для централизованного управления всей музыкальной библиотекой и версиями проектов. Вместо пересылки файлов, все участники процесса (продюсер, звукорежиссер, вокалист, заказчик) имеют доступ к единой временной шкале в облаке. Главной особенностью является система аудио- и видеоревью: клиент может выделить конкретный участок на волновой форме и оставить комментарий, например: «Сделай атаку на малом барабане острее в этом такте» или «Здесь вокал звучит слишком сухо, добавь пространственной обработки».
Помимо коммуникации, TuneFlow включает AI-инструменты для обработки аудио и берет на себя юридическую сторону продакшена — управление лицензированием и отслеживание авторских прав. Это особенно критично для коммерческих студий, которые покупают права на сэмплы или делят роялти между соавторами. Для внедрения платформы в пайплайн студии сервис предлагает 14-дневный бесплатный пробный период. После тестирования индивидуальные продюсеры могут перейти на тариф Small ($15 в месяц без НДС), продвинутые команды — на тариф Pro ($39 в месяц без НДС), а крупные лейблы — на Business ($99 в месяц без НДС). Уточнять возможность оплаты этих тарифов картой из РФ необходимо непосредственно на сайте платформы, так как условия эквайринга могут меняться.
Реставрация аудиоархивов и борьба с артефактами
Одной из самых сложных задач в звукорежиссуре является восстановление старых, поврежденных или плохо записанных аудиофайлов. Будь то оцифровка редкой кассеты с записью репетиции легендарной группы, подкаст, записанный в гулком кафе, или интервью на улице с сильным ветром — традиционные инструменты (гейты, фильтры и эквалайзеры) имеют физические ограничения. Если частота полезного сигнала (например, голоса) совпадает с частотой шума (например, гул кондиционера или шум ветра), обычный эквалайзер вырежет их вместе, сделав голос неестественным, «булькающим» или лишенным высоких частот.
Нейросети подходят к этой проблеме принципиально иначе. Обучившись на огромных массивах данных, где системе попарно предъявлялись записи «чистый голос» и «тот же голос с добавленным шумом», алгоритм научился буквально перерисовывать отсутствующие или поврежденные участки спектрограммы. Он не вырезает частоты, а синтезирует (восстанавливает) полезный сигнал на основе математического предсказания. Это позволяет убрать не только постоянный (белый или розовый) шум, но и динамические помехи: щелчки винила, лай собаки на заднем фоне, звон посуды или звук проезжающего мимо мотоцикла.
Однако при агрессивной обработке нейросети могут генерировать специфические цифровые артефакты. Голос может приобрести легкий металлический или роботизированный оттенок, а транзиенты ударных инструментов могут «размазаться», потеряв первоначальную хлесткость (punch). Чтобы минимизировать эти эффекты, профессионалы используют технику параллельной обработки (parallel processing). Суть заключается в том, чтобы сделать копию оригинальной дорожки, применить к ней максимальное шумоподавление с помощью ИИ, а затем аккуратно подмешать этот очищенный сигнал к оригиналу. Таким образом, мы сохраняем естественные гармоники и микродинамику исходника, но значительно снижаем общий уровень нежелательного фона. При этом, если в процессе восстановления вам необходимо увеличить разрешение или улучшить качество старых фотографий (например, для оформления обложки восстановленного релиза на стриминговых платформах), вы можете ознакомиться с проверенными инструментами в статье Как увеличить фото без потери качества нейросетью: апскейл-сервисы.
Будущее музыкального продакшена и искусственного интеллекта
Интеграция машинного обучения в музыкальную индустрию находится лишь в самом начале своего развития. Мы наблюдаем переход от офлайн-обработки файлов (когда нужно загрузить трек, подождать анализа и скачать результат) к обработке аудио в реальном времени с нулевой задержкой. Современные процессоры и видеокарты становятся достаточно мощными, чтобы локально запускать сложные алгоритмы сепарации и мастеринга прямо внутри цифровых звуковых рабочих станций (DAW) в виде стандартных VST-плагинов.
Инструменты вроде iMyFone MagicMic уже демонстрируют эту тенденцию, обеспечивая изменение голоса с помощью AI-фильтров в реальном времени, что критически важно для геймеров и стримеров. Это требует сложнейших вычислительных процессов, так как алгоритм должен успеть проанализировать входящий аудиопоток, извлечь из него тембральные характеристики, применить к ним новую математическую модель (например, голос другого человека или существа) и вывести звук на динамики без заметной для человеческого уха задержки (обычно менее 15 миллисекунд).
В генеративной музыке (такой как AI Song) вектор развития направлен на более точный контроль над композицией. Если сейчас пользователь управляет процессом в основном через текстовые запросы, то в будущем ожидается глубокая интеграция нейросетей с MIDI-данными. Вы сможете наиграть простую мелодию на фортепиано одним пальцем, а нейросеть мгновенно допишет к ней полноценную симфоническую аранжировку в стиле Ганса Циммера, бас-линию в стиле фанк и барабанную партию, учитывая все законы музыкальной гармонии и голосоведения. При этом сервисы управления студией, такие как TuneFlow, будут автоматически фиксировать все этапы изменений, обеспечивая прозрачность создания и четкое распределение авторских прав между человеком-оператором и алгоритмами.
FAQ: частые вопросы
Как работают нейросети для улучшения качества песен?
Нейросети используют алгоритмы машинного обучения, натренированные на миллионах аудиофайлов. В отличие от традиционных эквалайзеров, которые просто увеличивают или уменьшают громкость определенных частот, искусственный интеллект анализирует контекст аудио. Он способен отличать голос от шума толпы, партию гитары от партии баса и резонансы комнаты от полезного сигнала. Алгоритм не просто вырезает грязь, он перестраивает спектрограмму, синтезируя поврежденные или утерянные частоты (например, при низком битрейте MP3), стремясь восстановить звук до идеального студийного эталона.
Можно ли из старой моно-записи сделать современный стерео-микс?
Да, это один из самых востребованных сценариев работы современных AI-алгоритмов. Сначала старая моно-запись (например, оцифровка с магнитной ленты) загружается в инструмент для стем-сепарации (аналогичный Drumless, но работающий со всем спектром инструментов). Нейросеть разделяет монолитный файл на отдельные дорожки: вокал, ударные, бас и мелодию. Затем звукорежиссер загружает эти отдельные стемы в рабочую станцию, очищает их от шума и панорамирует: бас и бочку оставляет в центре (моно), а гитары, синтезаторы и бэк-вокал разводит по левому и правому каналам, создавая полноценное широкое стереозвучание.
Достаточно ли бесплатного тарифа для профессиональной студийной работы?
В большинстве случаев бесплатных тарифов достаточно только для ознакомления с качеством алгоритмов или для разовых, мелких задач контент-мейкеров. Например, платформа Drumless предоставляет бесплатную пробу с жестким ограничением в 10 МБ, чего хватит на короткий сэмпл, но не на полноценную коммерческую композицию. Сервис генерации музыки AI Song имеет разовую квоту для старта, но при регулярной работе требует подписки от $8 в месяц при годовой оплате. Для ежедневного сведения, мастеринга и реставрации аудио профессиональным студиям необходимо закладывать бюджет на премиальные тарифы или пожизненные лицензии (как в случае с десктопными версиями AnthemScore by Lunaverus от $29).
Безопасно ли загружать неизданные треки клиентов в облачные AI-сервисы?
Вопрос конфиденциальности и защиты интеллектуальной собственности критически важен в музыкальной индустрии (особенно до официального релиза трека). Большинство авторитетных профессиональных сервисов прописывают в пользовательском соглашении отказ от претензий на ваши авторские права и обязуются не использовать ваши загрузки для публичного обучения своих открытых моделей без разрешения. Платформы, предназначенные для организации студийного процесса, такие как TuneFlow, изначально заточены на безопасность файлов, лицензирование и управление правами внутри закрытого рабочего пространства. Однако перед загрузкой конфиденциальных мультитреков всегда следует внимательно читать условия использования конкретного сервиса.
Чем отличаются сервисы изменения голоса от обычных вокальных процессоров?
Традиционные вокальные процессоры, питч-шифтеры (pitch shifters) и вокодеры работают по математическим алгоритмам сдвига тональности. При сильном изменении голоса они неизбежно создают эффект «бурундука» (при повышении тона) или робота, так как вместе с основным тоном сдвигают и форманты — естественные резонансы грудной клетки и гортани человека. Нейросетевые сервисы, такие как iMyFone MagicMic, полностью анализируют входящий аудиосигнал, определяют фонемы и интонации, а затем генерируют совершенно новый голос в реальном времени, сохраняя ваши эмоции, но наделяя речь естественными акустическими характеристиками другого человека, персонажа или диктора. Это звучит намного реалистичнее и используется в кино, играх и на стримах.
Кому принадлежат авторские права на песни, сгенерированные нейросетью?
Вопрос авторского права на ИИ-музыку зависит от условий конкретной платформы. Сервисы вроде AI Song, генерирующие музыку и песни с помощью ИИ онлайн, часто разрешают коммерческое использование треков пользователям платных тарифов (от $8 в месяц при годовой оплате). Однако, поскольку произведения создаются алгоритмом без традиционного творческого вклада человека, во многих юрисдикциях их нельзя официально зарегистрировать как вашу личную интеллектуальную собственность. Такие сгенерированные композиции идеально подходят для фонового оформления видеороликов, подкастов или инди-игр, позволяя избежать страйков за нарушение чужих авторских прав, но могут вызвать юридические трудности при попытке эксклюзивного релиза через крупные музыкальные лейблы.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.