Как улучшить качество голоса нейросетью: убираем шум онлайн
Узнайте, как улучшить качество голоса нейросетью: подробный обзор платформ для очистки шума, генерации речи, разбор тарифов, правовых аспектов и инструкций.
Содержание статьи9
- Зачем нужна глубокая очистка звука и как работают современные алгоритмы
- Обзор платформ для работы со звуком и речью
- Пошаговый сценарий: как убрать фоновый шум и сделать речь кристально чёткой
- Согласие и закон: правовые аспекты использования нейросетей
- Типичные ошибки при обработке аудиодорожек новичками
- Практические сценарии применения интеллектуальных инструментов
- Как правильно выбрать подходящий сервис для своих конкретных задач
- Примеры запросов и тонких настроек для генерации и обработки
- FAQ: частые вопросы пользователей
Создание качественного звукового сопровождения для видеороликов, подкастов, образовательных курсов или музыкальных треков постоянно сталкивается с проблемой посторонних звуков, гулкого эха помещений и недостатков используемого записывающего оборудования. Если еще несколько лет назад для решения подобных проблем требовалась дорогостоящая аренда профессионально подготовленной студии, покупка флагманских микрофонов и долгие часы кропотливой ручной работы квалифицированного звукорежиссера, то сегодня каждый создатель контента может улучшить голос нейросетью прямо в окне своего браузера. Современный искусственный интеллект способен не только эффективно убирать сложный фоновый шум, но и синтезировать невероятно естественную речь, клонировать вокальные данные, а также до неузнаваемости изменять тембр в режиме реального времени. В этой статье мы максимально подробно разберем, как именно работают современные алгоритмы машинного обучения, какие платформы предоставляют передовой инструментарий для авторов и как правильно выстроить весь процесс обработки аудиодорожек, чтобы получить плотное студийное звучание даже из черновой записи, сделанной на обычный смартфон в неидеальных акустических условиях.
На цифровом рынке сегодня существует огромное множество специализированных платформ, каждая из которых решает свои узконаправленные задачи и предлагает уникальный подход к работе со звуком. Мы детально рассмотрим возможности таких сервисов, как ElevenLabs для профессионального синтеза и транскрибации, Overdub для генерации речи и внесения текстовых правок в аудио, а также многофункциональный облачный комбайн RecCloud для работы с субтитрами и переводом медиафайлов. Для геймеров, стримеров и авторов прямых трансляций будет особенно интересен iMyFone MagicMic, меняющий звучание прямо во время эфира, а для музыкантов и саунд-продюсеров — Controlla Voice. Кроме того, мы разберем платформу Звукограм, которая отлично справляется с синтезом текста и предоставляет пользователям обширную библиотеку готовых эффектов. Все эти высокотехнологичные инструменты доказывают одну важную вещь: очистить аудиодорожку с помощью ИИ сегодня может любой пользователь, независимо от его предыдущего технического бэкграунда и знаний в области классической звукорежиссуры.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| ElevenLabs | Преобразование текста в речь, клонирование, дубляж, транскрибация, создание музыки и голосовых агентов | От $6 в месяц (тариф Starter) | Есть ($0 в месяц) | Уточняйте на сайте сервиса |
| Overdub | Реалистичная генерация речи, голосовые правки из текста, клонирование собственного тембра | От $16 в месяц (при годовой оплате планов Descript) | Есть ($0 в месяц) | Уточняйте на сайте сервиса |
| RecCloud | Расшифровка, субтитры, перевод, озвучивание аудио/видео, генерация видео и редактирование | От ~$4 в месяц (при годовой оплате), есть недельные и бизнес-тарифы | Есть (бесплатный доступ и пробные функции) | Уточняйте на сайте сервиса |
| iMyFone MagicMic | Изменение голоса в реальном времени, AI-фильтры, звуковые эффекты для игр и стримов | От $9,99 в месяц (доступны годовой и пожизненный планы) | Есть | Уточняйте на сайте сервиса |
| Controlla Voice | Генерация песен, замена и клонирование вокала, разделение стемов, хоровая обработка | От $4/мес (годовая оплата), далее $8 и $20/мес | Есть | Уточняйте на сайте сервиса |
| Звукограм | Синтез речи из текста, транскрибация, библиотека звуковых эффектов и музыки | Пополнение от 150 ₽ за 150 токенов (1 токен = 1 ₽), разовые пакеты | Есть | Открывается без обходных путей, оплата картой РФ |
Зачем нужна глубокая очистка звука и как работают современные алгоритмы
В процессе любой, даже самой тщательно подготовленной записи звука, микрофон неизбежно улавливает огромное количество нежелательных частот и звуковых артефактов. Это может быть низкочастотный гул системного блока компьютера, монотонный шум кондиционера, звуки проезжающих машин за окном, отражение вашего собственного голоса от голых бетонных стен (что создает эффект реверберации), громкие щелчки механической клавиатуры или случайные резкие вздохи диктора. Традиционные методы цифровой обработки сигналов, такие как параметрические эквалайзеры, многополосные компрессоры и классические нойз-гейты (пороговые шумоподавители), работают по принципу жесткого отсечения определенных частотных диапазонов или порогов громкости. Главная проблема такого классического подхода заключается в том, что фоновый шум практически всегда находится в том же самом частотном диапазоне, что и полезный сигнал (человеческая речь). При попытке агрессивно вырезать гул улицы обычным эквалайзером, человеческая речь мгновенно становится неестественно глухой, теряет свою теплоту и начинает звучать так, словно человек говорит из глубокой бочки или по старой телефонной линии.
Современные технологии на базе нейросетей кардинально изменили этот устоявшийся десятилетиями процесс. Чтобы сделать речь качественнее алгоритмами, команды разработчиков обучают сложнейшие архитектуры на десятках миллионов часов чистых студийных записей, а также на огромных массивах аудиофайлов с искусственно подмешанными помехами различных типов. Алгоритм машинного обучения анализирует спектрограмму загруженного аудиофайла в динамике и буквально понимает на смысловом уровне, где находится сложная гармоническая структура человеческого голоса, а где — случайный, хаотичный фоновый мусор. Нейросеть не просто банально глушит определенные частоты, она бережно восстанавливает полезный сигнал, математически достраивая те гармоники и обертоны, которые могли быть повреждены или полностью заглушены внешними помехами во время записи. Это позволяет спасти даже те важные интервью, которые были записаны в переполненном шумном кафе, на оживленной улице в час пик или в ветреную погоду, превращая их в достойное подобие студийных сессий. Если вас интересует комплексный подход к созданию контента и вы хотите расширить свой арсенал, полезно будет подробно изучить, какая нейросеть для озвучки текста и замены голоса оптимально подходит для ваших текущих проектов.
Помимо банального удаления статического и динамического гула, современные интеллектуальные сервисы способны эффективно устранять так называемый эффект «комнаты». Акустика неподготовленного помещения создает сотни ранних микро-отражений звука, которые очень сильно дешевят любую, даже самую интересную запись. Алгоритмы распознают эти запаздывающие отражения и фазовые сдвиги, после чего аккуратно вычитают их из исходного сигнала. Таким образом, обработка аудио искусственным интеллектом позволяет независимым создателям контента экономить колоссальные финансовые средства на закупке акустического поролона, строительстве вокальных звукоизоляционных кабин и приобретении дорогих узконаправленных микрофонов, перенося всю тяжесть вычислительной работы на мощные удаленные облачные серверы.
Обзор платформ для работы со звуком и речью
Современный рынок предлагает невероятно разнообразные решения для авторов контента, подкастеров, музыкантов и представителей бизнеса. Мы собрали подробную и актуальную информацию о самых заметных и функциональных игроках в этой нише, опираясь исключительно на данные, предоставленные самими сервисами на их официальных ресурсах. Каждый из представленных ниже инструментов имеет свою четкую специализацию, уникальную ценовую политику, систему лимитов и набор функций, которые могут закрыть как базовые потребности абсолютного новичка, так и сложные, многоуровневые задачи профессиональной студии продакшена.
ElevenLabs
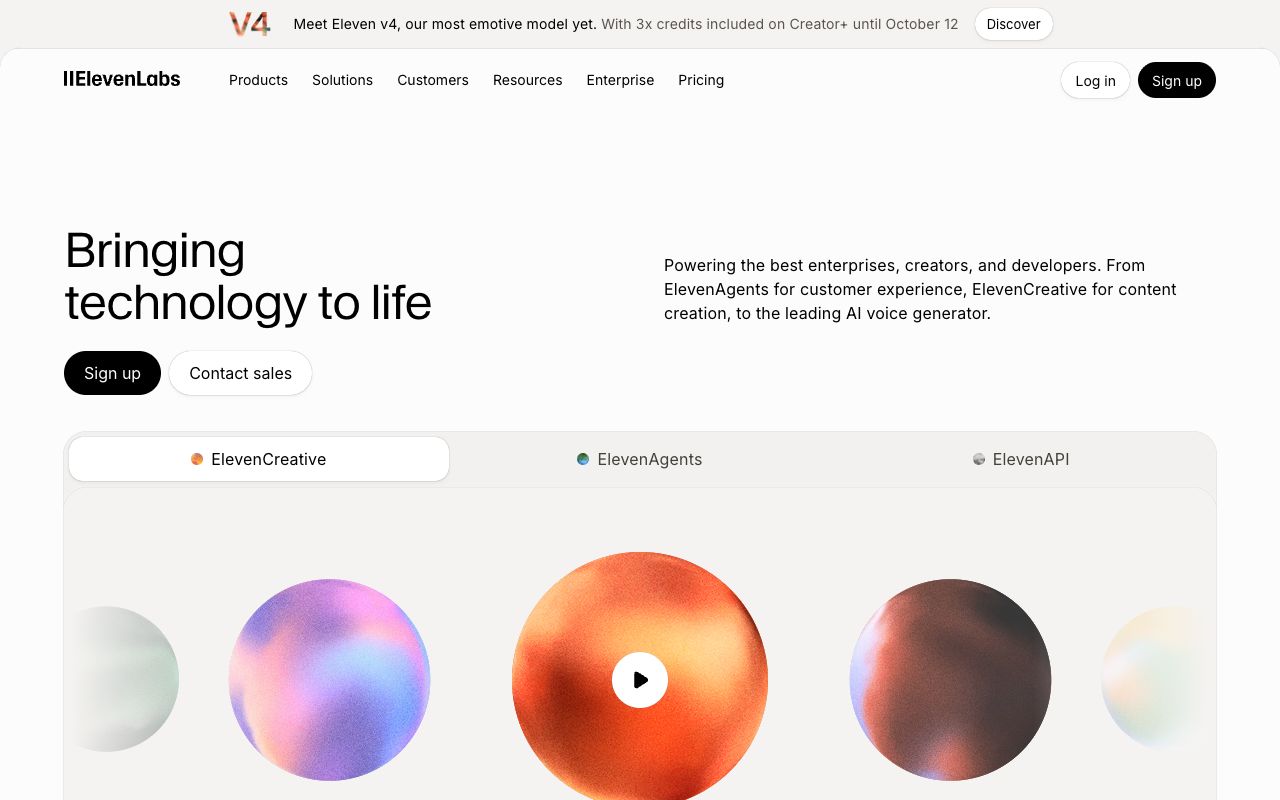
ElevenLabs позиционируется на мировом рынке как сверхмощная платформа для комплексной работы с речевыми технологиями. Сервис преобразует написанный текст в поразительно естественную речь, позволяя создавать полноценные аудиокниги, озвучивать длинные видеоролики, документальные фильмы и корпоративные презентации с высочайшей степенью реалистичности, учитывая интонации, дыхание и микропаузы. Одной из ключевых и самых востребованных особенностей является возможность клонировать и создавать совершенно новые, несуществующие в реальности голоса, что открывает огромные перспективы для авторов, желающих масштабировать свой контент без постоянного нахождения у физического микрофона. Помимо этого, платформа предоставляет продвинутые инструменты для точной транскрибации, автоматизированного дубляжа видео на другие языки с сохранением оригинального тембра, а также функционал для работы с музыкой, звуковыми эффектами и создания умных интерактивных голосовых агентов для бизнеса.
Ценовая политика компании отличается высокой гибкостью. Для начинающих пользователей или тех, кто просто хочет протестировать базовые возможности системы без финансовых вложений, предусмотрен бесплатный тариф за $0 в месяц. Если для реализации проекта требуются расширенные лимиты символов, доступ к премиальным моделям и разрешение на коммерческое использование сгенерированного материала, платные тарифы начинаются со Starter, который обойдется в $6 в месяц. Информацию о стабильности доступа к сервису и возможности оплаты услуг российскими банковскими картами уточняйте на сайте сервиса, так как эти условия подвержены изменениям.
Overdub
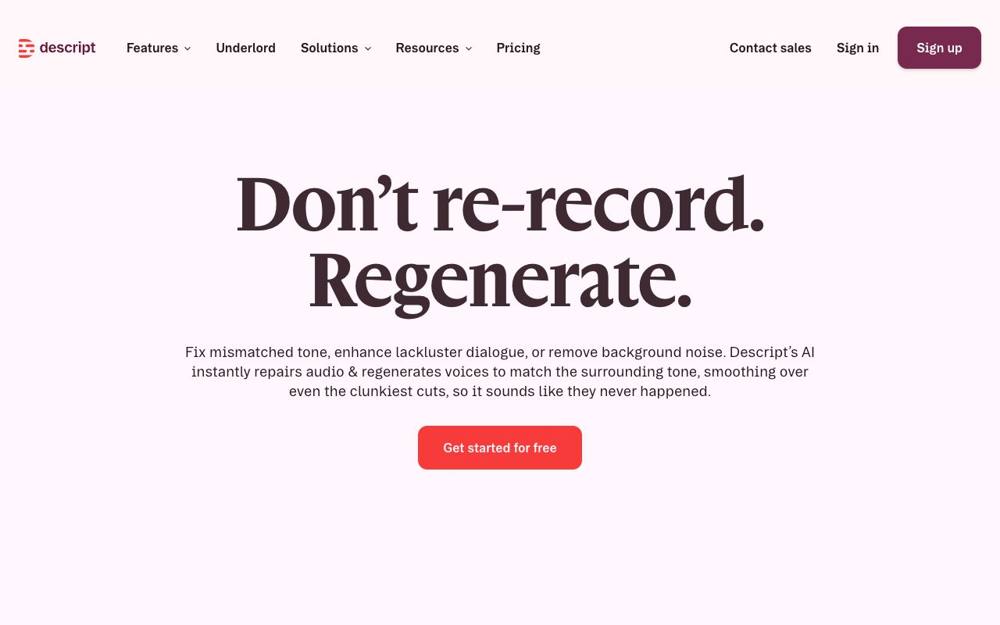
Overdub, являющийся неотъемлемой частью мощной экосистемы Descript, представляет собой по-настоящему инновационный инструмент для создателей подкастов, интервьюеров и видеомонтажеров. Этот сервис генерирует реалистичную речь и позволяет вносить голосовые правки прямо из текстового редактора. На практике это означает колоссальную экономию времени: если диктор случайно оговорился при записи длинного дубля, неправильно произнес сложный термин или пропустил целое предложение, больше не нужно заново настраивать оборудование и перезаписывать этот фрагмент. Пользователю достаточно просто исправить текст в транскрипции, и алгоритм бесшовно сгенерирует исправленное слово, используя предварительно созданное клонирование собственного тембра диктора. Это кардинально меняет весь традиционный процесс постпродакшена.
Новым пользователям доступен бесплатный тариф за $0 в месяц, который позволяет на практике ознакомиться с концепцией редактирования аудио через текст. Для регулярной, объемной и профессиональной работы потребуются платные планы Descript, стоимость которых начинается от $16 в месяц при условии оформления годовой оплаты. Что касается вопросов стабильного подключения из России и актуальных способов внесения абонентской платы, все эти детали уточняйте на сайте сервиса непосредственно перед началом работы.
RecCloud
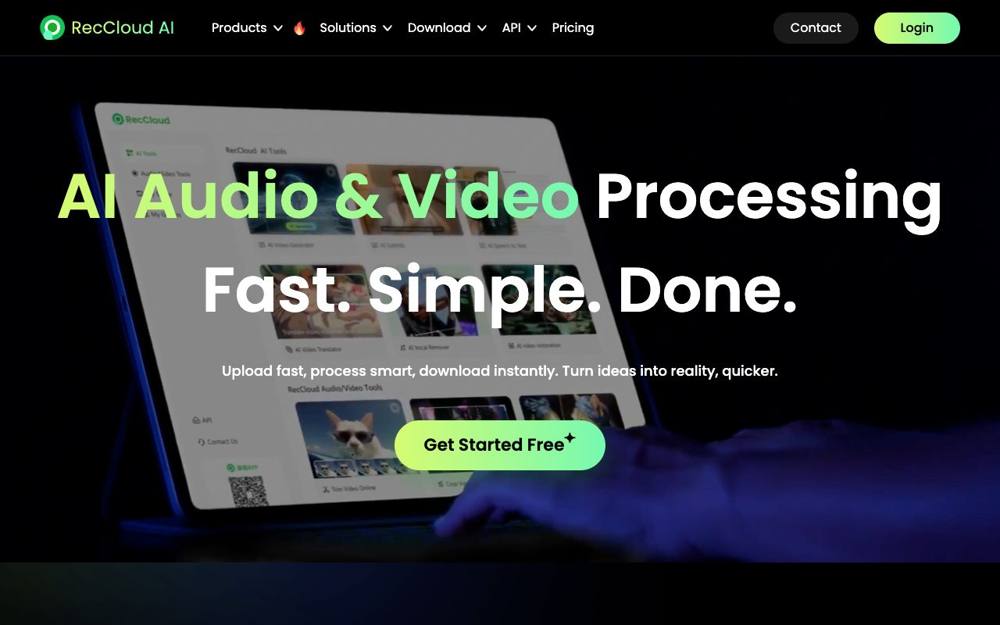
Платформа RecCloud представляет собой обширный, многоцелевой набор ИИ-инструментов, ориентированных на комплексную работу как с аудио, так и с видеоконтентом. Сервис предоставляет мощные возможности для быстрой расшифровки многочасовых записей, автоматического создания точных субтитров, перевода и последующего озвучивания материалов. Кроме того, богатый функционал включает передовые инструменты для генерации видео и всестороннего редактирования контента в облаке. Это делает данную платформу отличным выбором для профессиональных локализаторов, YouTube-блогеров и крупных образовательных проектов, которым требуется максимально быстро переводить и адаптировать свои обучающие материалы для широкой международной аудитории.
Для всех новых пользователей сервисом предусмотрен бесплатный доступ и пробные функции, чтобы оценить качество распознавания и перевода. Платные тарифы отличаются вариативностью: они начинаются примерно от $4 в месяц при условии выбора годовой оплаты. Для тех авторов, кому мощный инструментарий нужен на очень короткий срок или исключительно для разового коммерческого проекта, доступны удобные недельные тарифы, а для крупных корпоративных клиентов — специализированные бизнес-тарифы с расширенными квотами. Актуальные вопросы, связанные с доступом из РФ и доступными вариантами оплаты, уточняйте на сайте сервиса.
iMyFone MagicMic
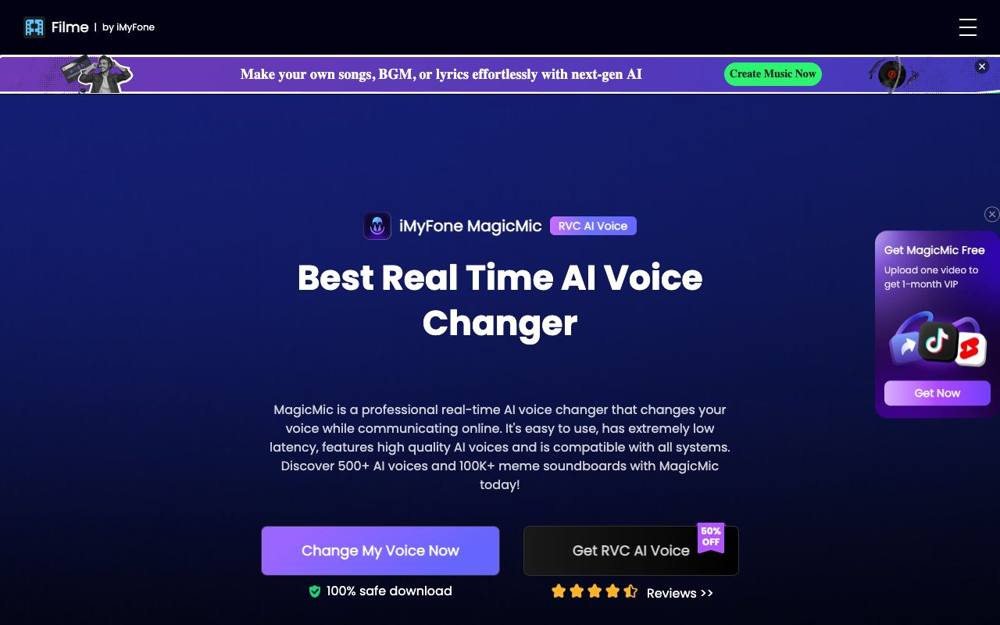
В отличие от большинства инструментов, предназначенных исключительно для неспешного постпродакшена, iMyFone MagicMic сфокусирован на мгновенной обработке звукового потока в реальном времени. Этот сервис изменяет голос с помощью продвинутых AI-фильтров непосредственно во время живого разговора, что делает его крайне популярным и востребованным решением среди геймеров, стримеров, пранкеров и активных пользователей голосовых чатов (таких как Discord, Skype, TeamSpeak). Помимо глубокой трансформации тембра в любых персонажей, программа предоставляет пользователю обширную библиотеку звуковых эффектов (так называемый саундборд), которые можно мгновенно активировать горячими клавишами во время прямых эфиров для создания комедийных ситуаций.
Свободно протестировать базовый функционал программы можно благодаря наличию бесплатного тарифа. Если же для ваших трансляций потребуется полный, неограниченный доступ ко всем существующим AI-моделям, пресетам и библиотекам эффектов, платная версия обойдется от $9,99 в месяц. Для тех стримеров, кто планирует использовать программу на постоянной основе долгосрочно, доступны также годовой и пожизненный планы, которые в перспективе оказываются гораздо более выгодным вложением. Доступность скачивания дистрибутива и прохождения оплаты из России уточняйте на сайте сервиса.
Controlla Voice
Controlla Voice — это узкоспециализированная, но невероятно мощная платформа, созданная специально для музыкантов, вокалистов, битмейкеров и саунд-продюсеров. Этот инструмент способен генерировать целые песни и кардинально преобразовывать исходный вокал с помощью обученного AI. Среди самых впечатляющих и технологичных функций платформы: полная замена голоса, точное клонирование вокальной манеры, качественное разделение стемов (позволяющее чисто извлечь акапеллу или инструментальную минусовку из уже сведенного, готового трека), сложнейшая хоровая обработка из одной дорожки и создание собственных, уникальных голосовых моделей. Это позволяет композиторам в кратчайшие сроки создавать потрясающие демо-записи с профессионально звучащим, поставленным вокалом, не прибегая к дорогостоящим услугам сессионных певцов.
Начать увлекательное знакомство с музыкальным ИИ можно через базовый бесплатный план. Платные тарифы, открывающие доступ к студийному качеству рендера, при годовой оплате стартуют от $4 в месяц. По мере роста профессиональных потребностей в серверных мощностях и увеличения лимитов можно легко перейти на более старшие, объемные планы за $8 и $20 в месяц соответственно. Информацию о том, как получить стабильный доступ к платформе и без проблем оплатить подписку из РФ, уточняйте на сайте сервиса.
Звукограм
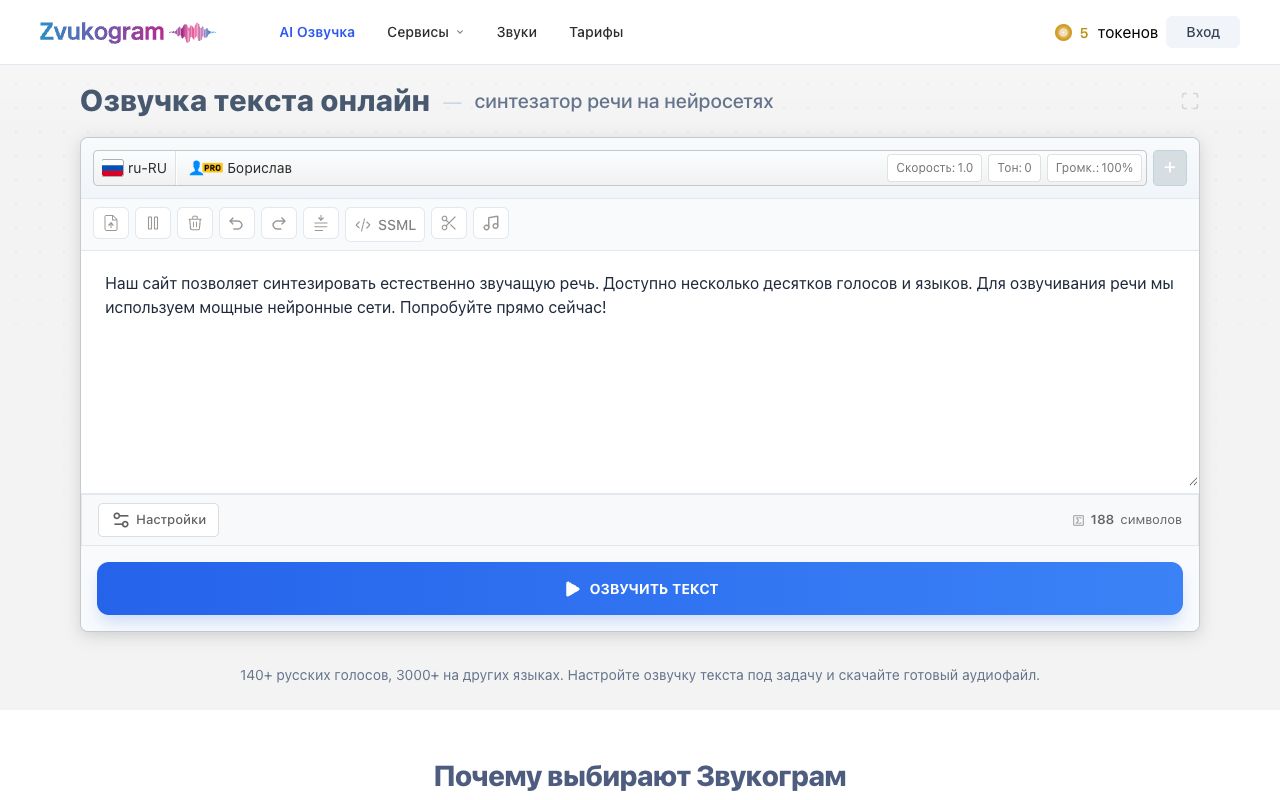
Отечественная платформа Звукограм ярко выделяется на фоне многих западных аналогов своей исключительной доступностью, понятным интерфейсом и глубокой адаптацией под русский язык. Данный сервис синтезирует естественную речь из загруженного текста, качественно транскрибирует длинные аудиозаписи в форматированный текст и предоставляет пользователям огромную базу звуковых эффектов и фоновой музыки для свободного скачивания. Это превосходный, надежный рабочий инструмент для создания закадровой озвучки рекламных роликов, коротких видео формата шортс, рилсов и информационных видеоэссе, особенно в тех случаях, когда требуется безупречная работа со сложной фонетикой и интонациями русского языка.
Финансовая модель этой платформы кардинально отличается от классических, навязываемых западными сервисами ежемесячных подписок. Пополнение внутреннего баланса аккаунта начинается всего от 150 ₽ за 150 токенов (где действует простая и прозрачная формула: 1 токен равен 1 ₽). Сервис предлагает исключительно разовые пакеты пополнения, а не сгорающую месячную подписку, что невероятно удобно для авторов с нерегулярными, плавающими задачами: вы платите ровно за тот объем символов, который реально используете в текущем проекте. Огромным, неоспоримым преимуществом для отечественных пользователей является то, что сайт свободно открывается без обходных путей, а прямая оплата картой РФ полностью поддерживается процессингом сервиса.
Пошаговый сценарий: как убрать фоновый шум и сделать речь кристально чёткой
Процесс работы с интеллектуальными ИИ-платформами для обработки и реставрации звука во многом технически унифицирован. Чтобы успешно улучшить голос нейросетью, избавиться от дефектов и получить на выходе плотное профессиональное звучание, необходимо строго следовать проверенному алгоритму действий. Этот универсальный пошаговый сценарий отлично подойдет для взаимодействия с большинством существующих сегодня облачных онлайн-сервисов.
Во-первых, критически важно правильно подготовить исходный аудиофайл перед загрузкой. Искусственный интеллект способен творить настоящие чудеса реставрации, но он далеко не всесилен. Постарайтесь в любом доступном вам аудиоредакторе перед экспортом обрезать длительные пустые участки тишины в самом начале и в самом конце вашей записи. Это необходимо для того, чтобы не тратить лимиты (внутренние токены) платформы впустую на просчет тишины. Убедитесь, что ваш итоговый файл сохранен в поддерживаемом платформой формате и с правильными характеристиками. Чаще всего облачные сервисы принимают распространенные форматы MP3, WAV, M4A или FLAC. Опытные инженеры настоятельно рекомендуют использовать именно WAV (16 bit или 24 bit, с частотой дискретизации 44.1 kHz или 48 kHz), так как это несжатый формат без потери качества. Алгоритмам будет в разы проще анализировать оригинальный спектр сигнала без цифровых артефактов жесткого сжатия, которые неизбежно присущи формату MP3.
Во-вторых, следует этап загрузки файла и тонкой настройки параметров фильтрации. После того как вы успешно зарегистрировались на выбранной вами платформе, найдите в интерфейсе профильный раздел, связанный непосредственно с улучшением аудио (он может называться Enhance Speech, Noise Reduction, Audio Restoration или схожим образом). Загрузите ваш подготовленный исходник. Большинство массовых сервисов имеют режим автоматической обработки (Auto), где умная нейросеть самостоятельно определяет тип преобладающего шума и необходимую степень его подавления. Однако, если платформа предоставляет пользователю мануальные ползунки интенсивности обработки, не спешите выкручивать их значения до максимума. Слишком агрессивная, чрезмерная обработка неизбежно приведет к появлению неприятных металлических, роботизированных артефактов в звучании голоса, уничтожив его бархатность. Начните тестирование с умеренного уровня обработки в 40-60% и внимательно прослушайте результат в хороших наушниках. Ваша главная цель — найти тот баланс, при котором раздражающий гул полностью исчезает, но естественные тембральные окрасы, теплота и живость вашей речи сохраняются в первозданном виде.
В-третьих, завершающий этап экспорта и финальная техническая доработка в редакторе. После того как алгоритм сервиса закончит сложный математический просчет (этот процесс может занять от нескольких секунд до нескольких десятков минут в прямой зависимости от длины загруженного медиафайла и текущей загруженности серверов компании), обязательно прослушайте полученный результат от самого начала и до самого конца. Обратите пристальное внимание на те моменты, где вы говорили слишком тихо, переходили на шепот, или где уличный шум был особенно громким и резким — иногда в таких сложных местах алгоритмы могут случайно "проглотить" или исказить окончания слов. Если итоговый результат вас полностью устраивает, скачайте очищенный файл на компьютер. Крайне рекомендуется скачивать результат исключительно в несжатом формате WAV для последующего беспроблемного монтажа в вашем любимом видеоредакторе. Очищенная нейросетью аудиодорожка станет великолепным фундаментом: теперь вы можете применить к ней легкую выравнивающую компрессию, а затем аккуратно наложить на фон тихую музыку, и ваш финальный ролик будет звучать дорого, чисто и максимально профессионально.
Согласие и закон: правовые аспекты использования нейросетей
Стремительное использование нейросетей для работы с человеческим голосом, в особенности когда речь заходит о точном клонировании, изменении тембра до неузнаваемости или генерации реалистичных дипфейков (deepfakes), строго и жестко регулируется действующим законодательством, а также общепринятыми этическими нормами. Очистить аудиодорожку с помощью ИИ, если это простое удаление гула холодильника из вашего собственного личного подкаста, можно совершенно свободно и без каких-либо опасений. Однако, как только технологии переходят тонкую грань базовой технической реставрации и начинают затрагивать вопросы интеллектуальной собственности и персональной идентичности, вступают в силу серьезные правовые ограничения.
Согласно положениям статьи 152.1 Гражданского кодекса Российской Федерации, обнародование и дальнейшее использование изображения гражданина (в том числе его фотографий, а также видеозаписей) допускаются исключительно с согласия этого гражданина. Аналогичные строгие правовые принципы и механизмы защиты персональных данных в полной мере применяются и к биометрическим данным, к которым, безусловно, относится уникальный голосовой слепок любого человека. Вы не имеете ни морального, ни юридического права скачивать чужие интервью, извлекать дорожку и загружать аудиозаписи с голосом другого человека в сторонние сервисы для создания его точного голосового клона без явно выраженного, а в идеале — задокументированного письменного согласия правообладателя.
Более того, большинство авторитетных платформ имеют собственные, крайне строгие правила использования (Terms of Service). Категорически запрещается создавать любой вводящий в заблуждение контент, цифровые подделки, аудиозаписи от лица действующих политиков, известных медийных личностей или частных лиц с целью мошенничества, вымогательства, шантажа или распространения заведомой дезинформации. Ответственные сервисы, предоставляющие сложную функцию клонирования, заставляют пользователя в режиме реального времени зачитать специальный верификационный текст, чтобы подтвердить, что он клонирует именно свой собственный голос, либо жестко требуют загрузки официального документального подтверждения прав на коммерческое использование голоса стороннего диктора. Грубое нарушение этих правил ведет не только к перманентной блокировке аккаунта на платформе без возможности возврата денежных средств, но и к серьезнейшей юридической ответственности, включая длительные судебные разбирательства и иски о защите чести, достоинства и деловой репутации. Искусственный интеллект — это мощнейший инновационный инструмент для созидания и творчества, но его использование всегда должно оставаться в строгих рамках закона и здравого смысла.
Типичные ошибки при обработке аудиодорожек новичками
Глубокая работа со звуком требует от человека определенной насмотренности, а в данном конкретном случае — профессиональной наслушанности. Новички, впервые получив в свои руки столь мощные интеллектуальные инструменты реставрации, часто совершают целый ряд типичных, повторяющихся ошибок, которые не только не улучшают исходный материал, но и могут его окончательно и бесповоротно испортить. Четкое понимание этих скрытых подводных камней поможет вам с самого начала создавать качественный коммерческий контент.
Первая и самая разрушительная ошибка — это чрезмерная интенсивность применяемого шумоподавления (так называемый Over-processing). Желая во что бы то ни стало добиться неестественной "вакуумной" тишины на фоне, неопытные пользователи выкручивают настройки AI-алгоритмов на максимальные значения. Закономерным результатом такого агрессивного вмешательства становится цифровое "бульканье", жесткое проглатывание тихих согласных звуков (особенно страдают шипящие и свистящие), и в итоге голос начинает звучать искаженно, как из дешевой портативной рации или длинной водопроводной трубы. Важно понимать, что хорошая живая запись совершенно не обязана быть полностью изолированной и стерильной. Легкий, едва уловимый естественный шум комнаты, так называемый "room tone", часто добавляет записи необходимой живости, объема и присутствия. Процесс цифровой реставрации звука идеологически очень похож на тонкую работу с изображениями: если вы решите изучить, как улучшить качество фото и реставрация старых снимков нейросетью работает на практике, вы легко заметите те же самые базовые принципы — избыточная программная сглаженность убивает естественную текстуру и превращает объект в пластмассовый манекен.
Вторая распространенная ошибка — полное игнорирование базовой акустики помещения на этапе физической записи. В среде начинающих блогеров существует опасный миф, что всемогущая нейросеть исправит всё. Из-за этой слепой веры начинающие подкастеры спокойно записывают многочасовые аудио в пустых, звонких комнатах с голыми параллельными стенами, создавая ужасающее гулкое эхо (флаттер), или снимают видео на улице при сильном порывистом ветре без пушистой ветрозащиты. И хотя AI действительно способен удалить значительную часть такой реверберации, алгоритму в процессе очистки приходится буквально "вырезать" огромные, важнейшие куски частотного спектра из сигнала, вместе с которыми безвозвратно уходит всё богатство, глубина и теплота вашего уникального тембра. Всегда, при любых условиях старайтесь записать максимально чистый, сухой исходник. Повесьте на окна плотные акустические шторы, положите на пол толстый ковер, используйте качественную ветрозащиту для микрофона — чем качественнее и чище будет ваш изначальный исходник, тем аккуратнее, незаметнее и бережнее сработает сложный алгоритм нейросети.
Третья техническая проблема кроется в неправильном выборе исходных форматов и двойном пережатии файлов. Запись аудио напрямую в популярном мобильном мессенджере (где звук уже в момент записи невероятно сильно сжат внутренними агрессивными кодеками платформы для экономии трафика) и последующая попытка обработать этот "убитый" файл в AI-сервисе неминуемо приведет к плачевным результатам. Алгоритму восстановления просто не за что "зацепиться", так как высокие частоты уже были безвозвратно срезаны кодеками мессенджера. Всегда записывайте звук в высоком несжатом разрешении, используя диктофоны или программы захвата (формат WAV, с частотой 44.1 kHz или 48 kHz, битностью 16 bit или 24 bit). Это правило невероятно похоже на работу с цифровой графикой: инженерам гораздо эффективнее увеличить фото без потери качества нейросетью, используя хороший, четкий исходник, чем безнадежно пытаться спасти сильно сжатый, разбитый на огромные пиксели файл, скачанный из социальных сетей.
Практические сценарии применения интеллектуальных инструментов
Сфера реального коммерческого применения речевых ИИ-технологий сегодня выходит далеко за рамки простого домашнего хобби. В настоящее время эти мощные инструменты глубоко интегрированы в профессиональные ежедневные рабочие процессы (пайплайны) огромного количества высокооплачиваемых специалистов из разных сфер. Давайте подробно рассмотрим основные сценарии, где сложная обработка аудио искусственным интеллектом приносит наибольшую, ощутимую пользу и экономит сотни часов рутинного труда.
Для подкастеров и создателей качественных YouTube-шоу.
Формат длительных разговорных видео и аудиоподкастов жестко требует высокой, кристальной разборчивости речи на протяжении всего выпуска. Подкастеры часто вынуждены записывать своих гостей удаленно через различные интернет-платформы, где качество сетевого соединения может внезапно падать, вызывая неприятные цифровые артефакты, прерывания, заикания и щелчки. Использование специализированных платформ для глубокой очистки звука позволяет звукорежиссерам выровнять дорожки всех участников беседы под единый, строгий студийный стандарт качества. Более того, встроенные инструменты транскрибации (автоматического перевода голоса в структурированный текст) помогают создателям мгновенно генерировать точные таймкоды для длинных видео, а также создавать субтитры, что критически важно для грамотной SEO-оптимизации роликов на хостингах и удержания огромной доли аудитории, которая предпочитает смотреть видео в ленте смартфона вообще без звука.
Для авторов аудиокниг и масштабных образовательных курсов.
Профессиональная запись многочасового, сложного образовательного курса требует огромной физической и эмоциональной выносливости диктора. Малейшая, незаметная простуда, усталость связок или просто легкое изменение настроения в разные дни неминуемо меняют тембр, из-за чего разные уроки одного курса начинают звучать вразнобой. Технология синтеза текста в речь (Text-to-Speech) блестяще решает эту извечную проблему индустрии. Используя высококачественные голосовые ИИ-модели, авторы курсов могут просто загружать текстовые сценарии своих уроков в систему и получать стабильно ровную, профессиональную, неутомимую озвучку, которая звучит одинаково хорошо в любой день недели. Если в будущем платформе потребуется обновить устаревший урок или срочно исправить фактическую оговорку, автору не нужно заново бронировать студию и вызывать диктора — достаточно просто изменить пару символов в текстовом редакторе проекта и перегенерировать короткий фрагмент за несколько секунд.
Для увлеченных геймеров, популярных стримеров и создателей развлекательного контента.
Многочасовые прямые эфиры на платформах требуют от программного обеспечения инструментов, работающих без ощутимых задержек, чтобы не рассинхронизировать звук с видеорядом веб-камеры. Программы для изменения голоса в реальном времени позволяют стримерам великолепно отыгрывать сложные роли (ролеплей) во время прохождения игр, мгновенно меняя свой естественный тембр на грубый голос огромного орка, металлический скрежет робота, высокий голос эльфа или персонажа противоположного пола. Это создает мощнейший комедийный, драматический или атмосферный эффект, значительно повышая общую вовлеченность и лояльность зрителей. А бесшовная интеграция с настраиваемыми саундбордами позволяет по нажатию всего одной горячей клавиши на клавиатуре включать закадровые аплодисменты зрительного зала, ситкомовский смех или тревожную музыку при появлении босса, превращая обычную, скучную домашнюю трансляцию в полноценное интерактивное ток-шоу.
Для профессиональных локализаторов и переводчиков контента.
Успешный выход популярного автора на международный рынок всегда был крайне сложной, дорогостоящей задачей из-за высокого языкового барьера. ИИ-инструменты, способные сегодня автоматически распознать оригинальную речь спикера в видео, литературно перевести её на другой язык, а затем сгенерировать новую, синхронную звуковую дорожку с полным сохранением оригинальных интонаций, пауз и эмоций автора, совершили настоящую революцию в индустрии дубляжа. Теперь независимые блогеры могут локализовать свои длинные ролики на испанский, немецкий, французский или японский языки буквально за считанные минуты и копейки, многократно расширяя свою потенциальную аудиторию и монетизацию.
Как правильно выбрать подходящий сервис для своих конкретных задач
При текущем колоссальном обилии заманчивых предложений на рынке технологий крайне легко запутаться в красивых маркетинговых обещаниях и по ошибке оплатить подписку на инструмент, который в итоге совершенно не решит вашу конкретную, узкую проблему. Чтобы сделать правильный, взвешенный выбор, необходимо с самого начала четко определить формат вашей ежедневной работы и строгие технические требования к финальному результату. Ваш выбор всегда должен базироваться на нескольких ключевых, фундаментальных критериях.
В самую первую очередь, необходимо точно определить тип вашей задачи: вам нужна исключительно качественная постобработка (вдумчивая очистка уже ранее записанного и сохраненного файла) или же вам критически важна работа алгоритмов в режиме реального времени? Если вы неспеша записываете видео для YouTube, монтируете документальный фильм или сводите записанный на диктофон подкаст, вам потребуются облачные сервисы постобработки с максимальным, бескомпромиссным качеством сложных математических вычислений. В таком случае задержка на рендер файла не играет никакой роли. Но если вы стримите игры на Twitch, ведете живые вебинары или общаетесь с командой в Discord, ваш единственный возможный выбор — это десктопные программы, устанавливаемые непосредственно на жесткий диск ПК, которые перехватывают цифровой сигнал с вашего аудиоинтерфейса на лету и обрабатывают его за миллисекунды за счет мощностей вашей видеокарты или процессора.
Второй важнейший критерий выбора — объективная потребность в синтезе и клонировании. Если ваша скромная цель — просто убрать раздражающий шум соседского перфоратора с вашей единственной голосовой записи, вам совершенно не нужны дорогие комплексные подписки на премиальные сервисы клонирования или перевода. В этом случае ищите простые, узконаправленные платформы, специализирующиеся исключительно на функции "Audio Enhancement". Если же вы, напротив, хотите создавать бесконечный контент без использования физического микрофона вообще (генерируя звук из текстовых файлов), пристально обращайте внимание на качество встроенных библиотек голосов, их эмоциональную гибкость, официальную поддержку русского языка и возможность мануально расставлять логические ударения, вздохи и паузы через специальную разметку (например, язык SSML).
Третий, не менее важный финансовый аспект — модель ценообразования сервиса. Трезво оцените ваши ежемесячные объемы производства. Если вы выпускаете всего один короткий ролик в месяц, нет абсолютно никакого коммерческого смысла платить за дорогую ежемесячную подписку, которая просто сгорит. В таком случае отличным и самым экономным выбором станут сервисы с системой покупаемых токенов или оплаты строго по факту использования минут (модель Pay-as-you-go). Если же вы ежедневно генерируете десятки часов контента, сразу ищите безлимитные тарифы на флагманских платформах или запрашивайте пакеты для бизнеса с фиксированной абонентской платой, чтобы не переплачивать астрономические суммы за случайный перерасход минут в конце месяца.
Примеры запросов и тонких настроек для генерации и обработки
Для того чтобы ваше взаимодействие с искусственным интеллектом было максимально предсказуемым и продуктивным, нужно уметь правильно, на понятном машине языке ставить ему задачи. Если при банальной очистке звука управление сводится лишь к осторожной регулировке ползунков интенсивности фильтров, то при синтезе речи из текста (Text-to-Speech) итоговый результат напрямую зависит от того, как именно вы составите текстовый промпт, какие знаки препинания используете и как настроите внутренние параметры модели. Вот несколько проверенных практических советов и примеров, как сделать речь качественнее алгоритмами при помощи грамотных запросов.
Управление живыми эмоциями и темпом диктора. Большинство современных продвинутых сервисов отлично понимают общий смысловой контекст загружаемого текста. Если вы хотите, чтобы голос звучал радостно, энергично и воодушевленно, обязательно добавьте в текст восклицательные знаки и соответствующие эмоциональные слова. Для создания драматических пауз используйте многоточия или специализированные теги (если сервис поддерживает синтаксис SSML).
Пример промпта для создания динамичного рекламного ролика: "Внимание! [пауза 1 секунда] Только сегодня... грандиозная распродажа! Успейте оформить заказ со скидкой." (Алгоритм считает паузу и восклицания, выдав очень энергичную подачу).
Пример для создания спокойного, медитативного повествования: "Закройте глаза... Сделайте глубокий, медленный вдох... Представьте себя на берегу ночного океана, где слышен лишь мягкий шелест набегающих волн." (ИИ безошибочно считает обилие многоточий и семантику слов, значительно замедлит темп чтения, сделав подачу максимально бархатной и расслабленной).
Настройка параметров клонирования (Voice Cloning). При создании и использовании собственного голосового слепка сервисы чаще всего предлагают пользователю тонкие настройки ползунков, таких как "Stability" (Стабильность), "Clarity" (Чистота сигнала) и "Style Exaggeration" (Усиление актерского стиля).
Низкая стабильность (параметр Stability: 20-30%) заставит ИИ звучать гораздо более эмоционально, живо, с легкими, непредсказуемыми изменениями в интонации, но при этом существенно повышает риск того, что голос может сорваться на фальцет, запнуться или сменить тональность в совершенно неожиданном месте предложения. Это отлично подходит для экспрессивного, художественного сторителлинга.
Высокая стабильность (параметр Stability: от 80 и выше) сделает голос диктора максимально ровным, уверенным, но слегка монотонным. Это отличный, надежный выбор для профессионального чтения сухих новостных сводок, скучных технических инструкций или строгих юридических текстов, где критически важна четкая подача без малейших лишних эмоций и актерствования.
Ручное исправление сложных ударений. Нейросети иногда досадно ошибаются в ударениях, особенно когда дело касается сложных, редких славянских фамилий, географических названий или узкоспециализированных медицинских терминов. Чтобы быстро исправить этот дефект, фонетически искажайте слова в тексте или используйте заглавные ударные гласные буквы, если сервис поддерживает такой простой синтаксис. Например, вместо слова "замок" (где ИИ обязательно запутается без контекста) пишите "замОк" (на двери) или "зАмок" (рыцарский) в зависимости от того, что именно вам нужно получить на выходе.
FAQ: частые вопросы пользователей
Можно ли полностью восстановить очень плохую запись со старого диктофона?
Искусственный интеллект способен невероятно эффективно снизить уровень монотонного шума, убрать гулкое эхо комнаты и сделать любую речь гораздо более разборчивой и приятной слуху. Однако важно понимать физику: алгоритм не может из воздуха восстановить ту акустическую информацию, которой изначально вообще нет в записанном файле. Если тихий голос человека был записан слишком далеко от микрофона, на фоне оглушающей музыки или сильного ураганного ветра, алгоритм может сильно исказить саму речь, отчаянно пытаясь отделить её от хаотичных помех. Полноценного студийного качества из черновой записи на старый кассетный диктофон в шумном вагоне метро получить не удастся, но итоговый результат точно станет разборчивым и пригодным для комфортного прослушивания.
Какой формат аудиофайла рекомендуется загружать в облако для обработки нейросетью?
Профессионалы звукорежиссуры настоятельно советуют всегда отдавать предпочтение аудиоформатам без потерь качества, таким как стандартный WAV (с параметрами 44.1 kHz, 16-bit или 24-bit) или FLAC. Популярные файлы MP3 уже имеют сильное цифровое сжатие алгоритмами кодека, при котором безвозвратно отсекается огромная часть высоких и низких частот. Когда интеллектуальная нейросеть пытается анализировать и обработать уже жестоко сжатый файл, многократно возрастает риск появления неприятных металлических артефактов, свиста и "бульканья" в голосе.
Будет ли рядовому слушателю заметно, что мой текст озвучила не живая персона, а нейросеть?
Объективное качество современных флагманских платформ машинного обучения достигло такого впечатляющего уровня, что на коротких отрезках текста (например, в 15-секундных рекламных роликах или коротких шортсах) отличить ИИ от живого профессионального диктора практически невозможно даже для тренированного уха. Однако на очень длинных текстах (например, в многочасовых аудиокнигах) внимательный слушатель рано или поздно может заметить математически повторяющиеся паттерны вдохов или одинаковые микроинтонации в концах предложений. Чтобы избежать этого эффекта механистичности, рекомендуется разбивать лонгриды на небольшие абзацы и слегка менять настройки ползунков экспрессии перед генерацией каждого нового блока.
Законно ли мне использовать клонированные голоса известных медийных людей для озвучки своих YouTube видео?
Нет, без получения явного письменного согласия владельца оригинального голоса это незаконно с юридической точки зрения. Создание любых несанкционированных дипфейков с использованием уникальных голосов политиков, голливудских актеров, известных музыкантов или любых других частных лиц грубейшим образом нарушает их законные права на биометрические данные. Подобные действия могут стать веским основанием для мгновенной блокировки вашего аккаунта на платформе генерации, страйка на YouTube, а также привести к реальным судебным искам с требованием компенсации. Используйте в работе только те голоса, на которые у вас есть задокументированные права, либо используйте встроенные, полностью легальные royalty-free библиотеки, предоставляемые самими сервисами.
Почему при попытке очистки звука от легкого шума мой естественный голос стал звучать как у робота?
Это классический, самый распространенный симптом чрезмерно агрессивной обработки аудиосигнала. Алгоритм цифрового шумоподавления в настройках сервиса был установлен вами на слишком высокий уровень интенсивности. В результате программа жестко удалила не только фоновый шум кондиционера, но и полезные обертоны и гармоники, формирующие уникальный тембр вашего голоса. Чтобы исправить эту неприятную ошибку, просто вернитесь в редактор сервиса, отмените действие и снизьте уровень подавления шума до значений 40-60%, позволив намеренно оставить минимальный, едва заметный естественный фон помещения.
Требуются ли мне для работы очень мощные, дорогие компьютеры, чтобы улучшать аудио нейросетями?
Для комфортной работы с подавляющим большинством существующих облачных SaaS-сервисов мощный, дорогостоящий компьютер с игровой видеокартой не нужен вообще. Вся сложнейшая, ресурсоемкая математическая обработка, спектральный анализ файлов и сама генерация аудио происходят исключительно на удаленных, сверхмощных серверах компании-провайдера. От вас требуется только наличие стабильного интернет-соединения для загрузки исходников и скачивания готовых файлов, а также любой современный веб-браузер. Единственное исключение составляют те десктопные программы, которые работают в режиме реального времени (например, для мгновенного изменения голоса в онлайн-играх) — они действительно могут требовать наличия современных процессоров для бесперебойной потоковой обработки сигнала без задержек.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.