Нейросеть для создания звуков и шумовых эффектов онлайн
Обзор платформ и алгоритмов для генерации звуков, синтеза речи и изменения голоса онлайн. Сравнение функционала, тарифов и возможностей интеграции.
Содержание статьи8
- Популярные платформы для работы со звуком
- Как выбрать подходящий инструмент для ваших задач
- Типичные ошибки при работе с аудиоинтерфейсами
- Сценарии использования: от игр до презентаций
- Пошаговый алгоритм: создаем звуковой проект
- Примеры запросов и настройки параметров
- Интеграция аудио в сторонние проекты
- FAQ: частые вопросы
Генерация аудиоконтента с помощью алгоритмов стала неотъемлемой частью работы создателей контента, разработчиков и маркетологов. Когда требуется озвучить видео, добавить фоновый шум или подготовить полноценный подкаст, на помощь приходят специализированные платформы. Если вам нужна нейросеть создать звук, современный рынок предлагает десятки решений: от простых генераторов шумовых эффектов до сложных систем синтеза речи и изменения голоса в реальном времени. Эти инструменты позволяют существенно сократить время на поиск актеров озвучки, покупку дорогостоящего оборудования и многочасовую работу в аудиоредакторах.
В этом материале мы подробно разберем функционал и особенности шести популярных сервисов: iMyFone MagicMic, Звукограм, Steosvoice, Silero TTS, VoiceBot и Slidecast. Каждая платформа имеет свою специфику: одни ориентированы на стримеров и геймеров, другие — на бизнес-презентации или транскрибацию. Мы рассмотрим их возможности, тарификацию и доступность, чтобы вы могли подобрать оптимальный инструмент для реализации ваших творческих и коммерческих задач в сфере звукового дизайна.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| iMyFone MagicMic | Изменение голоса в реальном времени, эффекты для стримов | От $9.99 в месяц (есть годовые и пожизненные планы) | Есть | Уточняйте на сайте сервиса |
| Звукограм | Синтез речи, транскрибация, эффекты и музыка | Пополнение от 150 ₽ за 150 токенов (разовые пакеты) | Есть | Открывается без обходных путей, оплата картой РФ проходит |
| Steosvoice | Синтез речи из текста, озвучка разными голосами | От 2 $/мес. (есть планы за 6 и 10 $/мес.) | Есть (ограниченный доступ) | Открывается без обходных путей, оплата — уточняйте на сайте |
| Silero TTS | Синтез речи и API для преобразования текста в аудио | Рассчитывается индивидуально по запросу | Уточняйте на сайте сервиса | Уточняйте на сайте сервиса |
| VoiceBot | Голосовое управление играми и приложениями (команды) | От 19 USD единоразово (без подписки) | Есть (бессрочно) | Уточняйте на сайте сервиса |
| Slidecast | Презентации с аудио и видео, аналитика, публикация | От $15/мес. (Creator), $29/мес. (Pro), от $99/мес. (Enterprise) | Есть | Уточняйте на сайте сервиса |
Популярные платформы для работы со звуком
Индустрия аудиоинструментов на базе искусственного интеллекта развивается стремительно, предлагая решения для самых разных сценариев. Ниже представлен подробный разбор функционала сервисов, которые помогают работать со звуком, голосом и мультимедийными презентациями. Каждая платформа имеет уникальные особенности, которые делают ее привлекательной для определенной целевой аудитории.
iMyFone MagicMic
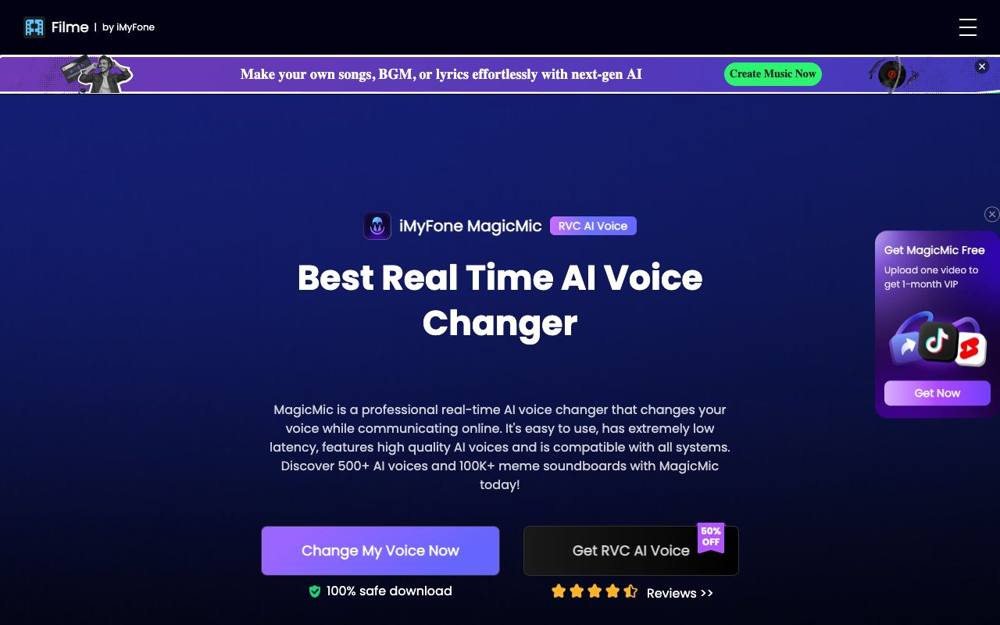
Сервис iMyFone MagicMic специализируется на работе с голосовым потоком. Инструмент изменяет голос пользователя в реальном времени, используя алгоритмы искусственного интеллекта. Это решение особенно востребовано среди стримеров, геймеров и создателей развлекательного контента, которым необходимо добавить динамики в свои эфиры или чаты. Платформа предоставляет не только фильтры для трансформации голоса, но и встроенную библиотеку звуковых эффектов, которые можно активировать во время игровых сессий или прямых трансляций.
Платформа предлагает бесплатный тариф, который позволяет ознакомиться с базовым функционалом. Для тех, кому требуется расширенный набор фильтров и эффектов, предусмотрена платная версия. Стоимость подписки начинается от $9,99 в месяц, при этом пользователям также доступны годовой и пожизненный планы, что позволяет выбрать оптимальный формат оплаты в зависимости от длительности проекта. Что касается доступа из Российской Федерации и возможности оплаты российскими банковскими картами, эту информацию необходимо уточнять на сайте сервиса, так как условия могут меняться.
Звукограм
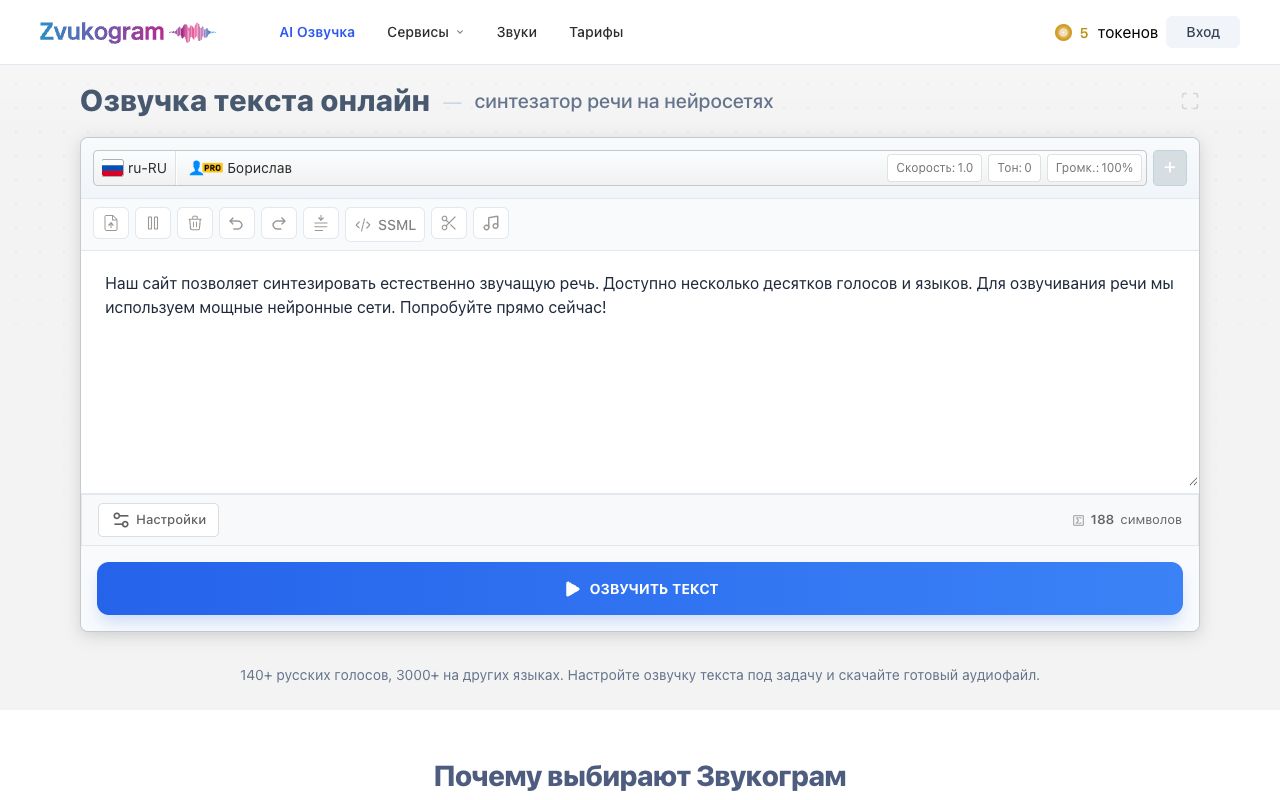
Платформа Звукограм представляет собой многофункциональный инструмент для работы с аудио и текстом. Основные возможности включают синтез естественной речи из текстовых документов и обратный процесс — транскрибацию аудиозаписей в текст. Кроме того, сервис предоставляет пользователям доступ к базе звуковых эффектов и музыкальных треков, доступных для скачивания, что делает его удобным решением для видеомонтажеров и подкастеров, которым требуется комплексное звуковое оформление.
Сервис предлагает бесплатный тариф, а платная модель построена на системе токенов, что исключает необходимость оформления регулярной месячной подписки. Пользователи приобретают разовые пакеты: минимальное пополнение составляет 150 ₽ за 150 токенов (из расчета 1 токен = 1 ₽). Это удобно для тех, кому инструмент нужен не на постоянной основе, а для решения точечных задач. Платформа открывается без обходных путей из России, и оплата российскими картами поддерживается в полном объеме.
Steosvoice
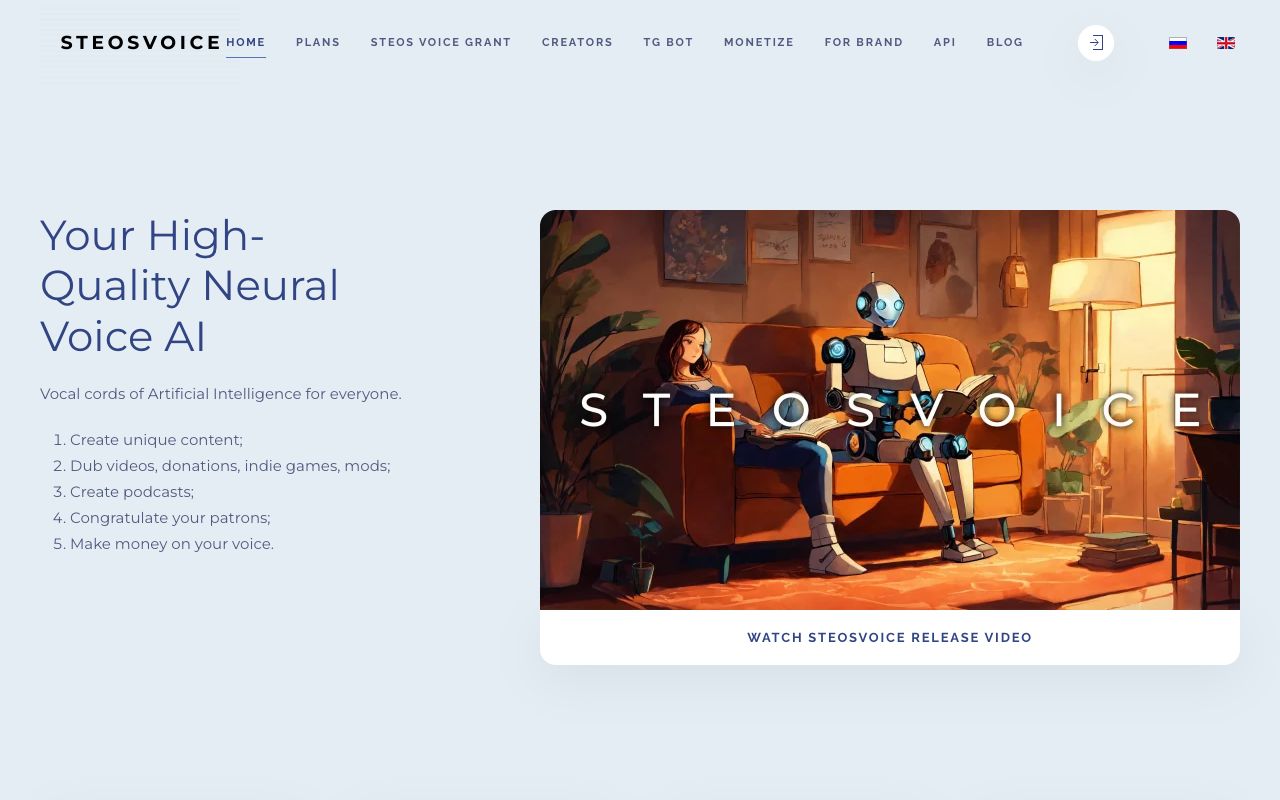
Инструмент Steosvoice сфокусирован на высококачественном синтезе речи. Платформа позволяет преобразовывать текстовые сценарии в аудиоформат, предоставляя выбор различных голосов. Это полезно при создании обучающих материалов, озвучивании инди-игр, подготовке аудиокниг и генерации голосовых уведомлений. Алгоритмы стараются передавать интонационные особенности, что делает звучание более естественным по сравнению со старыми технологиями текстового синтеза.
Для новых пользователей предусмотрен бесплатный тариф с ограниченным доступом, который дает возможность протестировать качество генерируемых голосов. Коммерческое использование и расширенные лимиты доступны в рамках платных тарифов, стоимость которых начинается от 2 $/мес. Для более объемных задач предусмотрены планы за 6 и 10 $/мес. Сайт открывается без обходных путей, однако вопросы, связанные с оплатой российскими картами, требуют уточнения на сайте сервиса.
Silero TTS
Проект Silero TTS ориентирован в первую очередь на разработчиков и корпоративных клиентов. Сервис предоставляет технологии синтеза речи из текста, а также предлагает API для интеграции функций преобразования текста в аудио в сторонние приложения, сервисы и устройства. Подобные решения активно применяются при разработке голосовых помощников, систем автоматического оповещения, колл-центров и умных устройств, где требуется программная генерация голоса.
Модель распространения Silero TTS отличается от потребительских сервисов. Стоимость коробочного и облачного программного обеспечения рассчитывается индивидуально по запросу клиента, в зависимости от масштабов проекта и требуемых мощностей. Наличие бесплатного тарифа для ознакомления, а также условия доступа и оплаты из Российской Федерации не имеют фиксированных публичных параметров, поэтому все детали необходимо уточнять на сайте сервиса.
VoiceBot
VoiceBot предлагает принципиально иной подход к работе со звуком — он использует ваш голос в качестве контроллера. Сервис предназначен для голосового управления играми и различными приложениями. Пользователь может создавать и настраивать собственные голосовые команды, которые преобразуются в нажатия клавиш, макросы или клики мыши. Это мощный инструмент как для геймеров, стремящихся автоматизировать рутинные действия в сложных симуляторах, так и для пользователей, нуждающихся в альтернативных способах управления компьютером.
Базовая версия VoiceBot доступна пользователям бессрочно и бесплатно. Для тех, кому требуются продвинутые функции управления макросами и профилями, предлагаются Pro-лицензии. Их стоимость начинается от 19 USD, при этом оплата производится единоразово — никаких ежемесячных подписок не предусмотрено. Возможность приобретения лицензии с помощью российских карт и доступность ресурса из РФ следует уточнять на сайте сервиса.
Slidecast
Slidecast — это платформа, объединяющая визуальный и звуковой контент в едином формате. Сервис предназначен для создания, публикации и совместного использования мультимедийных презентаций. Его ключевая особенность заключается в возможности добавления аудио- и видеосопровождения к слайдам, что превращает статичную презентацию в полноценный интерактивный материал. Кроме того, платформа предоставляет инструменты аналитики, позволяющие отслеживать, как аудитория взаимодействует с контентом.
Пользователи могут начать работу с бесплатного плана. Профессиональные функции доступны на платных тарифах: тариф Creator обойдется в $15/мес., план Pro стоит $29/мес., а решения уровня Enterprise начинаются от $99/мес. Информацию о том, как получить доступ к сервису из России и произвести оплату, необходимо уточнять на официальном сайте платформы.
Как выбрать подходящий инструмент для ваших задач
Многообразие платформ часто вызывает трудности при выборе конкретного решения. Чтобы не тратить время и бюджет на инструменты, которые не подходят для ваших целей, необходимо четко определить формат работы со звуком. Инструменты классифицируются по нескольким основным направлениям: потоковая обработка, генерация из текста, транскрибация и голосовое управление. Понимание этой структуры поможет выстроить эффективный рабочий процесс.
Для создателей игрового контента, стримеров и видеоблогеров первостепенной задачей часто является взаимодействие с аудиторией в режиме реального времени. В этом случае требуются программы, способные захватывать звук с микрофона, применять фильтры и мгновенно выводить обработанный сигнал. Наличие встроенных саундбордов (панелей с шумовыми эффектами) также становится весомым преимуществом. Если ваша цель — разработка интерактивных проектов, рекомендуем также ознакомиться со статьей Нейросети для создания игр: ассеты, код, миры и персонажи, где описаны комплексные подходы к геймдеву.
Для маркетологов, специалистов по обучению и создателей подкастов важнее инструменты асинхронной работы. Синтез речи позволяет быстро озвучивать длинные тексты без привлечения дикторов. При выборе таких платформ стоит обращать внимание на систему тарификации: если вы работаете с короткими видеороликами время от времени, вам подойдут разовые покупки токенов. Если же производство аудиоконтента поставлено на поток, выгоднее рассматривать ежемесячные подписки с фиксированными лимитами или безлимитным доступом.
Типичные ошибки при работе с аудиоинтерфейсами
Даже самые продвинутые алгоритмы требуют правильного подхода. Пользователи часто сталкиваются с проблемами, которых можно избежать на этапе подготовки материала или настройки программного обеспечения. Одна из самых распространенных ошибок при синтезе речи — отправка в генератор "сырого" текста. Алгоритмы читают текст буквально, поэтому отсутствие знаков препинания, неправильные ударения в редких словах или использование аббревиатур без расшифровки приводят к неестественному, роботизированному звучанию. Текст необходимо предварительно размечать, расставляя точки, запятые и специальные символы пауз, если это поддерживается синтаксисом платформы.
При использовании сервисов потокового изменения голоса главной проблемой становится игнорирование акустики помещения и качества исходного микрофона. Алгоритм не способен полностью устранить сильное эхо пустой комнаты или громкий фоновый шум от вентиляторов компьютера. Фильтры накладываются поверх искаженного сигнала, что в итоге дает неразборчивый результат. Настройка чувствительности микрофона и базовое подавление шума до передачи звука в программу существенно повышают качество итогового аудиопотока.
Еще одна ошибка касается интеграции API для коммерческих проектов. Разработчики иногда недооценивают объемы запросов к серверу при массовом использовании функций синтеза речи в своих приложениях. Это приводит к быстрому исчерпанию лимитов или непредвиденным расходам, если тарификация идет за каждый символ или запрос. Перед интеграцией важно проводить нагрузочное тестирование и тщательно рассчитывать потенциальный расход квот, выбирая оптимальные модели лицензирования.
Сценарии использования: от игр до презентаций
Инструменты для работы со звуком применяются в самых разных отраслях, значительно упрощая рутинные процессы. Разберем несколько практических сценариев, которые демонстрируют, как именно применяются рассмотренные платформы в повседневной и профессиональной деятельности.
В сфере электронного обучения (e-learning) аудиовизуальный контент показывает наибольшую эффективность. Преподаватели и бизнес-тренеры формируют учебные материалы, комбинируя слайды и голосовые пояснения. Используя специализированные платформы для презентаций, автор может загрузить готовые визуальные материалы и наложить на них предварительно сгенерированный или записанный звук. Встроенная аналитика позволяет лектору видеть, на каких именно аудиослайдах слушатели задерживаются дольше всего, а где прерывают просмотр, что дает ценную обратную связь для улучшения курса.
Геймеры и создатели модификаций активно внедряют голосовые интерфейсы. В сложных симуляторах (например, космических или авиационных), где количество необходимых для управления кнопок превышает возможности стандартной клавиатуры, голосовое управление становится спасением. Игрок произносит заранее заданную команду, а программа моментально конвертирует ее в нужное сочетание клавиш. Это повышает уровень погружения и ускоряет реакцию на игровые события. Подробнее о генерации звукового сопровождения можно узнать в материале Нейросеть для создания музыки и ремиксов: обзор 5 сервисов 2026.
Для контент-менеджеров и редакторов важной задачей является перевод форматов. После записи интервью или подкаста возникает необходимость создания текстовой версии (статьи или субтитров). Инструменты транскрибации загруженного аудиофайла автоматически распознают речь и выдают текстовый документ. Затем этот текст может быть отредактирован и, при необходимости, заново озвучен другим голосом для создания локализованной версии ролика для зарубежной аудитории.
Пошаговый алгоритм: создаем звуковой проект
Для достижения предсказуемого и качественного результата при работе с онлайн-сервисами звукового синтеза и обработки, рекомендуется придерживаться структурированного алгоритма. Этот процесс минимизирует количество правок и экономит платные токены или лимиты подписки. Ниже представлен универсальный подход к созданию аудиоконтента.
- Подготовка исходных данных. Если вы работаете с текстом, напишите сценарий. Вычитайте его вслух. Замените сложные словесные конструкции на более простые, расшифруйте все сокращения (например, "ООО" напишите как "Общество с ограниченной ответственностью", если так требует контекст). Если речь идет о потоковом аудио, проверьте подключение гарнитуры и выберите микрофон в настройках операционной системы как устройство по умолчанию.
- Выбор параметров генерации или фильтрации. В интерфейсе платформы выберите подходящий профиль. Для синтеза речи это может быть выбор пола, возраста диктора, эмоционального окраса (радостный, строгий, нейтральный). Для изменения голоса — выбор нужного персонажа (робот, монстр, радиоэфир) и настройка ползунков высоты тона (Pitch) и тембра (Timbre).
- Тестовый запуск (проверка). Никогда не генерируйте большие объемы текста сразу. Выделите один абзац (или произнесите тестовую фразу в микрофон) и прослушайте результат. На этом этапе выявляются ошибки в ударениях или чрезмерные искажения при изменении голоса. Внесите корректировки в текст (добавьте знак ударения перед ударной гласной, если это поддерживается сервисом) или измените настройки фильтра.
- Финальная обработка и экспорт. Запустите полную генерацию или начните запись стрима. При сохранении готового файла обращайте внимание на формат (WAV предпочтительнее для дальнейшего монтажа, MP3 — для публикации в сети). После скачивания прослушайте итоговый файл целиком, чтобы убедиться в отсутствии артефактов и обрывов звука в конце дорожки.
Примеры запросов и настройки параметров
Качество взаимодействия с алгоритмами во многом зависит от того, насколько точно вы формулируете задачу. В системах синтеза речи (TTS) промптом является сам текст, но его форматирование играет решающую роль. Ниже приведены примеры того, как правильная разметка меняет восприятие сгенерированного звука.
- Базовый текст (читается монотонно): Привет сегодня мы поговорим о новых технологиях они меняют мир каждый день.
- Размеченный текст для TTS: Привет! ... Сегодня мы поговорим о н+овых технол+огиях. Они меняют м+ир, — каждый день. (Использование многоточий добавляет длинные паузы, тире меняет интонацию перед концовкой, а знаки плюса перед гласными явно указывают алгоритму на правильное ударение).
Для программ голосового управления логика "запросов" заключается в создании связок "Команда — Действие". При настройке профиля необходимо учитывать фонетическую четкость произносимых слов, чтобы алгоритм не перепутал команды.
- Неэффективная команда: "Переключить на второе оружие" (слишком длинно, в бою можно не успеть произнести).
- Оптимальная команда: "Ствол два" (коротко, фонетически контрастно) -> Назначаемое действие: Нажатие клавиши "2" на клавиатуре.
- Сложный макрос: Команда "Запуск протокола" -> Действие: Нажатие "Ctrl+Shift+E", задержка 500 миллисекунд, нажатие "Enter".
При оформлении аудиовизуальных презентаций важно синхронизировать звук со сменой слайдов. Если текст диктора на одном слайде длится 45 секунд, а визуальной информации там на 10 секунд, зритель потеряет интерес. Текст должен быть разбит на логические блоки, соответствующие таймингу визуальных элементов на экране.
Интеграция аудио в сторонние проекты
Звуковое сопровождение редко существует в вакууме; чаще всего оно является частью более сложного продукта: веб-сайта, мобильного приложения, игры или рекламного ролика. Интеграция сгенерированного аудио или API-сервисов требует понимания технических процессов и пользовательского опыта.
При создании веб-ресурсов звуковые эффекты используются для микроинтеракций — щелчки при нажатии кнопок, звуки успешной отправки формы или фоновая музыка на промо-страницах. Разработчики могут использовать готовые пакеты шумовых эффектов, скачанные с профильных платформ, и внедрять их через HTML5-тег <audio> или JavaScript. Если вас интересуют современные способы конструирования веб-страниц, полезно изучить статью Нейросеть для создания сайта по описанию: 5 сервисов без кода в 2026.
Корпоративные решения часто требуют более глубокого внедрения. Например, подключение сервиса синтеза речи к системе CRM позволяет автоматически генерировать голосовые сообщения для клиентов на основе их текстовых данных (имя, номер заказа, статус доставки). В таких случаях используются программные интерфейсы (API), где сервер компании отправляет текстовую строку на сервер нейросети и мгновенно получает аудиофайл, который затем отправляется клиенту через телефонию или мессенджер.
В сфере подкастинга и медиа интеграция заключается в сведении нескольких дорожек в виртуальных студиях или редакторах (DAW). Синтезированный голос диктора помещается на основную дорожку, шумовые перебивки и эффекты — на второстепенные, а фоновая музыка — на третью. Важно следить за балансом громкости (уровнем децибел), чтобы фоновые шумы и музыка не перекрывали основной информационный поток, а общая картина звучала гармонично.
FAQ: частые вопросы
Можно ли использовать сгенерированные голоса для коммерческих видео на YouTube?
Условия коммерческого использования зависят от конкретной платформы и выбранного тарифа. В большинстве случаев бесплатные планы предполагают использование контента только в личных, некоммерческих целях. Для монетизации роликов на видеохостингах, использования аудио в рекламе или при создании игр необходимо приобретать платные подписки или токены, которые предоставляют соответствующие лицензионные права. Перед публикацией обязательно изучайте пользовательское соглашение (Terms of Service) выбранного инструмента.
Чем отличаются сервисы изменения голоса от синтезаторов речи?
Сервисы изменения голоса (например, iMyFone MagicMic) работают с аудиосигналом в реальном времени. Вы говорите в микрофон, программа мгновенно обрабатывает частоты вашего голоса и накладывает фильтры, меняя тембр и высоту. Синтезаторы речи (TTS, такие как Steosvoice или Звукограм) работают с текстом. Они не требуют наличия микрофона: вы печатаете или вставляете готовый текстовый документ, а алгоритм генерирует аудиофайл, озвученный выбранным виртуальным диктором. Это принципиально разные технологии для разных задач.
Будет ли программа голосового управления работать с любой игрой?
Программы вроде VoiceBot конвертируют произносимые команды в стандартные команды устройств ввода (нажатия клавиш клавиатуры, клики или скроллинг мыши). Поскольку операционная система воспринимает эти сигналы так же, как если бы вы физически нажимали на кнопки, они совместимы практически с любой игрой или приложением на ПК. Исключение могут составлять агрессивные античит-системы в некоторых соревновательных онлайн-шутерах, которые могут блокировать программную эмуляцию нажатий клавиш.
Как улучшить интонацию при генерации голоса из текста?
Качество интонации зависит от модели ИИ и от того, как подготовлен исходный текст. Чтобы добиться максимально естественного звучания, используйте знаки препинания: запятые и тире создают короткие паузы, точки — длинные, а вопросительные и восклицательные знаки меняют тональность фразы в конце. Некоторые платформы поддерживают специальный язык разметки (SSML), который позволяет вручную указывать длительность пауз в миллисекундах, выделять конкретные слова логическим ударением и менять скорость произношения на определенных участках.
Можно ли оплатить зарубежные сервисы картой банка РФ?
Ситуация с оплатой зависит от каждого конкретного сервиса и его текущих платежных шлюзов. Например, платформа Звукограм принимает оплату картами РФ без проблем. Что касается зарубежных сервисов, таких как Slidecast, VoiceBot, Steosvoice или MagicMic, возможность прямой оплаты российскими банковскими картами может отсутствовать или периодически меняться. Актуальную информацию о доступных методах проведения платежей необходимо всегда уточнять на официальных сайтах сервисов или в их службе поддержки перед планированием бюджета.
Требуется ли мощный компьютер для работы с аудио в реальном времени?
Облачные сервисы, занимающиеся синтезом текста в речь или транскрибацией, выполняют все вычисления на своих серверах, поэтому для работы с ними достаточно браузера и стабильного подключения к интернету. Однако программы, изменяющие голос в реальном времени или обрабатывающие голосовые команды локально на ПК, требуют определенных ресурсов процессора и оперативной памяти для минимизации задержки (latency). Обычно системные требования не слишком высоки, но при параллельном запуске современных "тяжелых" игр и программ потокового вещания наличие современного многоядерного процессора крайне желательно.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.