Нейросеть для работы с PDF: топ лучших сервисов для анализа и редактирования
Ищете надежный ИИ для анализа документов? Разбираем востребованные платформы: цены, доступные тарифы, функционал и пошаговые инструкции по обработке файлов.
Содержание статьи7
- Подробный разбор ИИ-платформ для работы с документацией
- Критерии выбора ИИ-инструмента для ваших задач
- Пошаговый сценарий: как обрабатывать файлы с помощью ИИ
- Типичные ошибки пользователей при загрузке документации
- Примеры промптов для эффективного извлечения данных
- Корпоративное применение и автоматизация документооборота
- FAQ: частые вопросы
Современная нейросеть для работы с pdf представляет собой мощнейший аналитический инструмент, который радикально меняет подход к обработке информации. В условиях постоянно растущего объема корпоративной, учебной и личной документации рутинный поиск нужных данных отнимает недопустимо много времени. Будь то студенты, которым необходимо оперативно вычленить ключевые тезисы из десятков объемных научных монографий, юристы, вычитывающие многостраничные договоры на предмет скрытых рисков, или бухгалтеры, ежедневно сталкивающиеся с лавиной первичных счетов, искусственный интеллект способен взять на себя самую монотонную часть работы. Интеллектуальные платформы нового поколения умеют не просто считывать текстовые слои из цифровых файлов, но и распознавать сложные многоуровневые таблицы, извлекать строго заданные сущности и формировать на их основе новые, кристально четкие и структурированные аналитические отчеты. Внедрение подобных технологий в повседневную практику экономит специалистам десятки часов драгоценного времени ежемесячно, позволяя сосредоточиться на принятии стратегических решений, а не на механическом перелистывании страниц.
На сегодняшний день рынок программного обеспечения предлагает внушительное количество разнообразных решений, начиная от интуитивно понятных универсальных диалоговых интерфейсов и заканчивая узкоспециализированными корпоративными комплексами, требующими сложной интеграции. В рамках данного подробного обзора мы детально рассмотрим шесть востребованных продуктов: ChatGPT, Retext.ai, StudGPT, Nlogic, Smart Engines и Преферентум. Мы тщательно проанализируем их заявленные возможности, изучим тарифные сетки, проверим наличие бесплатных ознакомительных версий и актуальные условия доступа для пользователей. Собранная информация поможет вам объективно оценить каждую платформу и подобрать оптимальный инструмент, который будет в полной мере соответствовать вашим специфическим запросам, техническим навыкам и выделенному бюджету.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| ChatGPT | Общение, текст, изображения, голос, поиск, код, исследования | Платные тарифы от 20 долларов в месяц | Есть бесплатный план | Доступ: уточняйте на сайте. Оплата: уточняйте на сайте. |
| Retext.ai | Перефразирование, сокращение, генерация, исправление, чат | Премиум-функции от 12 долларов в месяц | Есть бесплатный тариф | Доступ: открывается без обходных путей. Оплата: уточняйте на сайте. |
| StudGPT | Учеба, задачи, тексты, изображения, документы | Платные тарифы от 299 ₽ в месяц | Бесплатный тариф — 0 ₽ (лимит 10 сообщений в день) | Доступ: открывается без обходных путей. Оплата картой РФ: доступна. |
| Nlogic | Обработка и ввод первичной документации | Cloud: от 190000 ₽ в год за 12000 страниц | Нет | Доступ: открывается без обходных путей. Оплата: уточняйте на сайте. |
| Smart Engines | SDK для распознавания удостоверений, форм, карт, кодов | Индивидуальный расчет | Уточняйте на сайте (демо и пробный SDK по запросу) | Доступ: уточняйте на сайте. Оплата: уточняйте на сайте. |
| Преферентум | Обработка неструктурированных данных, ЭДО, аналитика | Продукты от 100 000 ₽ | Уточняйте на сайте | Доступ: открывается без обходных путей. Оплата: уточняйте на сайте. |
Подробный разбор ИИ-платформ для работы с документацией
Процесс выбора подходящего цифрового инструмента напрямую зависит от того, с какими категориями файлов вы планируете взаимодействовать в своей ежедневной практике. Для анализа простых электронных отчетов с выделяемым текстом будет вполне достаточно базовых возможностей больших языковых моделей. Однако, когда речь заходит о массовой обработке отсканированных паспортов, рукописных анкет или сложной первичной бухгалтерской отчетности со множеством печатей, на первый план выходят мощные специализированные системы, оснащенные алгоритмами глубокого оптического распознавания символов. Ниже мы разберем сильные стороны и ограничения каждой из заявленных платформ, опираясь исключительно на официальные характеристики и данные сервисов.
ChatGPT
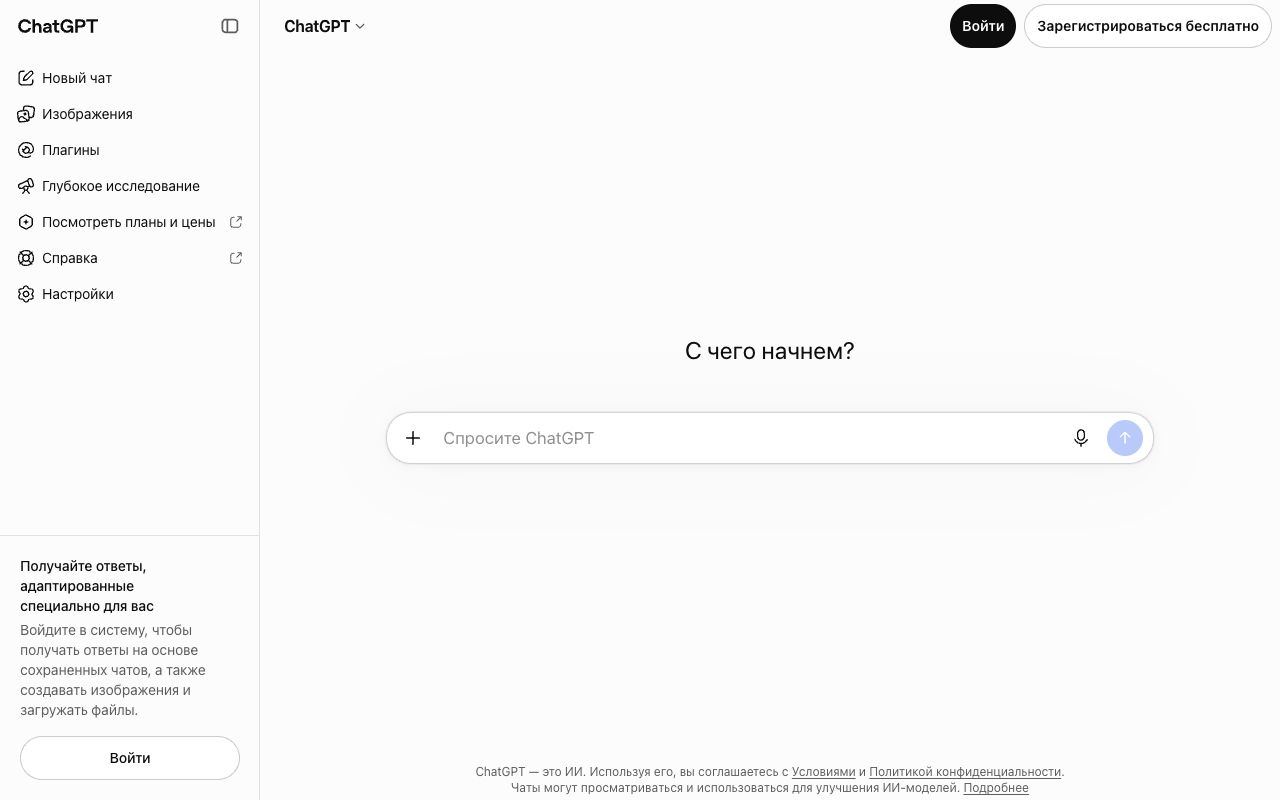
Данный инструмент представляет собой масштабный ИИ-сервис, который предоставляет пользователям богатейший арсенал функций для интеллектуального взаимодействия. Платформа создавалась как универсальный помощник и сегодня активно применяется для общения, генерации новых материалов, а также для глубокого анализа загруженного текста и визуальных данных (изображений). Одной из отличительных черт продукта является полноценная поддержка голосовых бесед, что выводит пользовательский опыт на принципиально иной уровень. Помимо этого, встроенные алгоритмы превосходно справляются с комплексным поиском информации в открытых источниках, выполнением рутинных исследовательских задач и даже написанием или отладкой программного кода.
Кому подходит: Максимально широкой аудитории. От программистов, ищущих ошибки в скриптах, и научных сотрудников, систематизирующих исследования, до писателей, маркетологов и финансовых аналитиков, которым требуется многозадачный и гибкий цифровой ассистент для работы с массивами разнородной информации.
Сильные стороны: Главное преимущество заключается в исключительной универсальности. Пользователь получает возможность не только проводить аналитику текстовых файлов, но и писать сложный программный код, проводить масштабные исследования и генерировать визуальный контент в рамках единого рабочего интерфейса. Наличие бесплатного плана позволяет новичкам комфортно начать работу и оценить базовые возможности системы без первоначальных финансовых вложений.
Ограничения и условия: Экосистема сервиса включает в себя несколько уровней подписки: помимо бесплатного плана, существуют платные тарифы Go, Plus, Business и Enterprise. Стоимость популярной подписки Plus начинается от 20 долларов в месяц. Что касается организационных вопросов, информацию о том, как получить доступ к платформе с территории Российской Федерации и существуют ли способы оплаты услуг российской банковской картой, необходимо уточнять непосредственно на официальном сайте разработчика.
Retext.ai
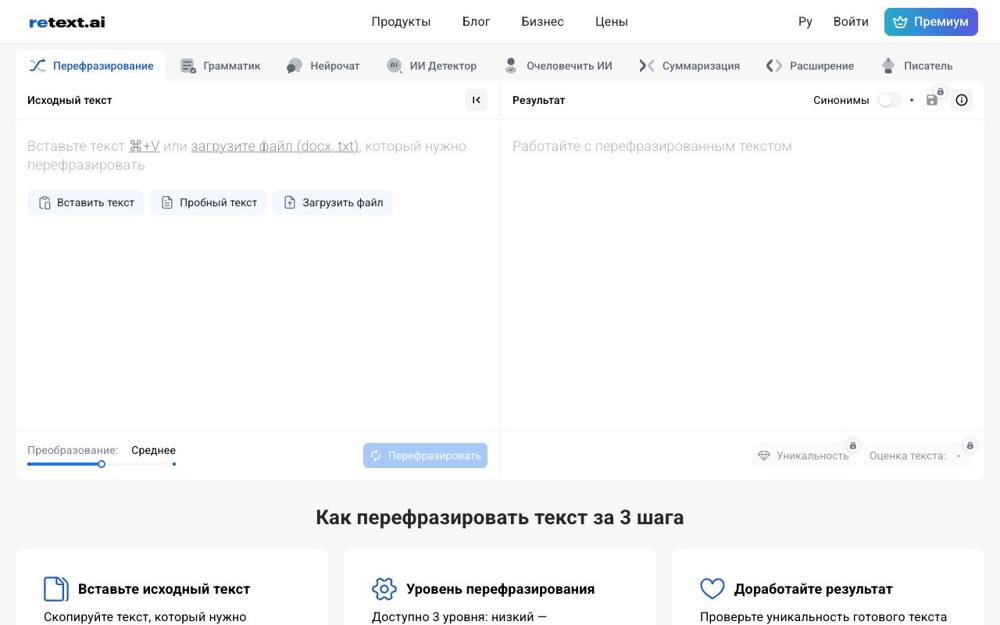
Эта платформа имеет ярко выраженную специализацию — она сконцентрирована на глубокой стилистической и смысловой переработке текстового контента. В основе сервиса лежат алгоритмы, позволяющие качественно перефразировать исходные материалы, грамотно сокращать избыточные тексты (выжимая суть) или, наоборот, расширять короткие тезисы до полноценных статей. Дополнительно система умеет автоматически находить и исправлять орфографические, пунктуационные и речевые ошибки, генерировать тексты с чистого листа по заданному описанию, а также выявлять контент, написанный другими нейросетями. Для удобства взаимодействия предусмотрен формат чата с ИИ.
Кому подходит: В первую очередь профессиональным редакторам, копирайтерам, контент-менеджерам, PR-специалистам, а также студентам и маркетологам. Всем тем, чья деятельность неразрывно связана с постоянной адаптацией текстовых материалов, изменением их формата, объема и общей тональности повествования.
Сильные стороны: Узкая, сфокусированная специализация на лингвистических задачах обеспечивает высокую точность при редактуре и переписывании абзацев. Пользователям доступен бесплатный тариф, который отлично подходит для тестирования функционала. Значимым плюсом является то, что сайт платформы открывается без обходных путей для пользователей из РФ, что упрощает повседневную эксплуатацию.
Ограничения и условия: Для полноценной работы и снятия лимитов потребуется подписка. Доступ к премиум-функциям предоставляется на платной основе, стоимость начинается от 12 долларов в месяц. Актуальные данные о возможности оплаты услуг с помощью российских банковских карт не подтверждены, поэтому детали транзакций следует уточнять на сайте сервиса перед началом использования.
StudGPT
Данный программный продукт позиционируется как специализированная нейросеть для учебы, созданная с учетом специфических потребностей образовательного процесса. Платформа оказывает существенную помощь в решении практических задач по различным дисциплинам, поддерживает глубокую работу с большими текстами, визуальными материалами (изображениями) и многостраничными документами. Подобный фокус на академические и учебные потребности делает сервис мощным инструментом для тех, кто ежедневно сталкивается с необходимостью усваивать большие объемы новых знаний и структурировать информацию.
Кому подходит: Учащимся старших классов, студентам колледжей и высших учебных заведений, аспирантам, а также преподавателям, которые ищут современного цифрового помощника для оперативного разбора сложных учебных материалов, подготовки конспектов и решения рутинных образовательных задач.
Сильные стороны: Важным преимуществом является прозрачная ценовая политика: сервис предлагает полностью бесплатный тариф (0 ₽), в рамках которого пользователю доступен лимит в 10 сообщений в день. Платформа открывается без обходных путей, что обеспечивает комфортный и стабильный рабочий процесс. Кроме того, оплата премиальных услуг картой РФ здесь полностью доступна, что снимает множество барьеров для локальных пользователей.
Ограничения и условия: Основное ограничение кроется в лимитах. При превышении квоты в 10 бесплатных сообщений в сутки дальнейшая работа потребует перехода на платные тарифы. Стоимость коммерческих подписок начинается от 299 ₽ в месяц, что является вполне подъемной суммой для активных студентов.
Nlogic
Представленный инструмент относится к категории серьезных B2B-решений. Это комплексная платформа, главная миссия которой заключается в тотальной автоматизации процессов обработки и ввода первичной документации. Внедрение подобных систем в корпоративный контур направлено на кардинальное сокращение трудозатрат линейного персонала, минимизацию человеческого фактора и ускорение обработки гигантских потоков бумажных и электронных актов, накладных и счетов-фактур.
Кому подходит: Крупным бухгалтерским отделам, центрам общего обслуживания (ОЦО), финансовым организациям, логистическим компаниям и любым масштабным предприятиям, через которые ежедневно в непрерывном режиме проходят сотни или тысячи страниц строгой отчетности.
Сильные стороны: Максимальный фокус на решении болей бизнеса — автоматизации рутины, снижении операционной нагрузки на сотрудников и повышении скорости принятия документов к учету. Сервис ориентирован на российский рынок и открывается без обходных путей.
Ограничения и условия: Поскольку это enterprise-продукт, классический бесплатный тариф для физических лиц здесь отсутствует. Финансовая модель построена на объемах: тарифы Cloud начинаются от 190000 ₽ в год за пакет в 12000 страниц. Итоговая стоимость внедрения и владения напрямую зависит от заявленного объема обрабатываемых страниц. Точные способы оплаты и юридические нюансы оформления договоров уточняйте на сайте сервиса.
Smart Engines
Этот продукт стоит особняком в нашем списке, так как представляет собой не конечный пользовательский интерфейс, а мощный SDK (набор средств разработки) для распознавания и извлечения данных. В основе лежат продвинутые алгоритмы машинного зрения. Система способна с высокой точностью работать с удостоверениями личности различных форматов, сложными бюрократическими документами, стандартизированными формами, банковскими картами, а также считывать штрихкоды и QR-коды. Решение является полностью кроссплатформенным: его можно внедрять на мобильных устройствах, интегрировать в веб-сервисы, устанавливать на десктопные ПК и серверы компаний.
Кому подходит: Системным интеграторам, разработчикам мобильных и веб-приложений, банкам, страховым корпорациям, финтех-стартапам и государственным структурам — всем тем, кому критически необходимо встроить надежную функцию оптического распознавания документов непосредственно в собственные программные продукты.
Сильные стороны: Поразительно широкий охват поддерживаемых типов данных — от паспортов и водительских прав до сложных акцизных марок и штрихкодов. Огромным плюсом является технологическая гибкость и возможность интеграции на любых платформах (веб, десктоп, мобильные устройства, серверы), что позволяет обрабатывать данные прямо на устройстве пользователя без отправки в облако.
Ограничения и условия: Учитывая специфику, розничных тарифов с фиксированной ценой здесь нет. Стоимость лицензирования рассчитывается строго индивидуально, в зависимости от функциональных запросов и количественных требований конкретного заказчика. Чтобы оценить качество работы, доступны демо-приложения и пробный SDK, однако предоставляются они исключительно по запросу. Вопросы, касающиеся доступа к полным версиям из РФ и возможности оплаты картой РФ, уточняйте на сайте сервиса. Информацию о наличии классического бесплатного тарифа также следует проверять на официальном ресурсе.
Преферентум
Платформа представляет собой высокотехнологичный комплекс для интеллектуальной обработки и глубокого анализа огромных массивов неструктурированных текстовых данных. В отличие от простых систем поиска по ключевым словам, данный ИИ понимает контекст, выявляет скрытые сущности, связи и закономерности. Основные направления применения этого инструмента — профессиональная текстовая аналитика и бесшовная интеграция в действующие системы электронного документооборота (ЭДО) крупных организаций.
Кому подходит: Крупным корпорациям, аналитическим центрам, юридическим департаментам, консалтинговым агентствам и службам безопасности, которым необходимо извлекать конкретные смыслы, выявлять фактологические связи и структурировать информацию из хаотичных архивов текстовых документов.
Сильные стороны: Продукт представляет собой профессиональный инструмент для текстовой аналитики корпоративного уровня, способный справляться со сложной лингвистикой и большими объемами корпоративной информации. Важным преимуществом для локального бизнеса является то, что сайт сервиса открывается без обходных путей из России.
Ограничения и условия: Внедрение подобных аналитических комплексов — это масштабный проект. Стоимость продуктов платформы начинается от 100 000 ₽. При этом окончательные финансовые условия всегда рассчитываются индивидуально, исходя из масштабов инфраструктуры и конкретных аналитических задач клиента. Подробную информацию о возможном наличии бесплатных тестовых версий и вариантах оплаты картой РФ уточняйте на сайте сервиса.
Критерии выбора ИИ-инструмента для ваших задач
Чтобы четко осознать, какая нейросеть для работы с pdf окажется наиболее полезной именно в вашей ситуации, необходимо провести детальный, вдумчивый аудит собственных рутинных процессов. Рынок предлагает совершенно разные по своей архитектуре и логике подходы: от простейших окон в браузере, куда достаточно просто перетащить файл мышкой, до сложнейших программных библиотек, требующих участия целой команды квалифицированных программистов для настройки API. Если вам особенно интересна тема глобального импортозамещения и поиска надежных локальных решений, настоятельно рекомендуем ознакомиться с аналитическим материалом Российские нейросети: аналоги зарубежных сервисов 2026, где крайне подробно разбираются архитектурные особенности локальных платформ.
Первый и основополагающий критерий выбора — это тип конечного пользователя, его техническая подготовка и реальные потребности. Если вы студент или аспирант, которому нужно оперативно найти конкретные ответы в объемной методичке или скомпилировать список литературы, вам совершенно не нужны дорогие корпоративные SDK. В таком сценарии оптимально выбрать пользовательский сервис с удобным диалоговым чатом и возобновляемыми бесплатными лимитами. Если же вы представляете интересы бизнеса, приоритеты меняются кардинально. Вам придется оценивать инструменты по строгим критериям отказоустойчивости, высокой пропускной способности, уровню защиты данных и наличию подробной документации для интеграции в существующий IT-ландшафт вашей компании.
Второй, не менее важный критерий — технический формат самих файлов, с которыми предстоит работать. Документы условно делятся на две большие группы. Первая — файлы, изначально созданные в цифровом виде (например, экспортированные из текстовых редакторов), где текст состоит из символов, которые можно выделить курсором. Для таких файлов подойдут практически любые языковые ИИ-модели, так как они читают символы напрямую. Вторая группа — это файлы, представляющие собой просто набор отсканированных картинок или фотографий страниц. В этом случае базовый текстовый ИИ окажется бессилен, и вам потребуются специализированные решения, оснащенные технологиями оптического распознавания символов (OCR). Дополнительно стоит всегда учитывать язык документации и наличие в ней нестандартных, сложных элементов: математических формул, многоуровневых графиков, нечетких синих печатей или размашистых рукописных подписей.
Третий важный момент, о котором часто забывают на этапе планирования — это выделенный бюджет и прогнозируемые объемы нагрузки. Разовую, нерегулярную задачу (например, проанализировать один договор аренды раз в полгода) вполне реально решить в рамках стартовых бесплатных тарифов, которые предоставляют некоторые диалоговые платформы. Однако при постоянной, потоковой работе, когда счет идет на сотни страниц в день, любые бесплатные лимиты исчерпаются буквально за часы. В таких обстоятельствах необходимо садиться за калькулятор и скрупулезно сравнивать экономику: что выгоднее в пересчете на один месяц — платить фиксированную абонентскую плату в иностранной валюте, покупать объемные пакеты страниц за рубли или запрашивать индивидуальный расчет стоимости бессрочной лицензии для автономной интеграции на собственных корпоративных серверах.
Пошаговый сценарий: как обрабатывать файлы с помощью ИИ
Грамотный, методичный подход к взаимодействию с искусственным интеллектом обеспечивает высочайшую точность и релевантность итоговых результатов. Наблюдения показывают, что многие пользователи разочаровываются в передовых технологиях просто потому, что систематически нарушают базовую последовательность действий при формировании запросов. Давайте подробно рассмотрим универсальный алгоритм работы, который применим к большинству популярных пользовательских (не корпоративных) диалоговых сервисов и помогает достичь максимального эффекта.
Шаг 1: Предварительная подготовка файла. Никогда не пренебрегайте этим этапом. Перед загрузкой обязательно убедитесь, что ваш файл физически не поврежден, открывается в стандартных просмотрщиках и не защищен паролем администратора. Если перед вами огромный многостраничный отчет, а вам объективно нужна аналитика только из одной конкретной главы, имеет смысл заранее разделить файл в любом бесплатном редакторе. Это позволит не тратить драгоценные лимиты системы (токены контекстного окна) на анализ совершенно ненужного текста. Также критически оцените качество сканирования, если вы работаете не с изначальным цифровым текстом: чем четче контуры букв и выше контрастность изображения, тем меньше фактических ошибок допустит алгоритм при расшифровке.
Шаг 2: Правильная загрузка и инициализация процесса. Откройте интерфейс выбранного сервиса и найдите элемент управления загрузкой (как правило, это интуитивно понятная иконка скрепки, плюса или выделенная область для drag-and-drop). Перенесите файл и обязательно дождитесь полного, стопроцентного окончания загрузки, пока индикатор не сообщит об успехе. В этот скрытый от глаз момент современные системы автоматически проводят сложную предварительную индексацию текста, разбивая его на смысловые фрагменты (чанки) и создавая векторную базу данных для последующего мгновенного поиска ответов.
Шаг 3: Формирование первого, калибровочного запроса. Распространенная ошибка — сразу требовать от ИИ сложных аналитических выводов на основе всего массива данных. Начните взаимодействие с базовой проверки того, насколько корректно система «прочитала» и осознала информацию. Напишите простую команду: «Опиши в трех предложениях, о чем этот документ» или «Перечисли основные разделы, которые ты видишь в оглавлении». Если полученный ответ полностью совпадает с реальностью, значит, индексация прошла успешно, и можно смело переходить к глубокой профильной работе.
Шаг 4: Итеративный анализ и прицельное извлечение данных. Задавайте максимально конкретные, узкие вопросы. Вместо абстрактного и размытого «Проанализируй этот длинный договор», используйте четкие, алгоритмизированные команды: «Найди в тексте все упоминания сроков оплаты и штрафных санкций. Выведи их в виде маркированного списка с обязательным указанием номеров соответствующих пунктов». Если ответ кажется вам неполным или поверхностным, не стесняйтесь попросить систему расширить его детализацию или поискать скрытую информацию в смежных разделах файла.
Шаг 5: Безопасный экспорт и обязательная финальная проверка результатов. Важно понимать: ни одна, даже самая совершенная автоматизированная система в мире, не застрахована от так называемых «галлюцинаций» — специфических ситуаций, когда ИИ предельно убедительно и складно выдает абсолютно выдуманную информацию за непреложный факт. Возьмите за правило всегда сверять критически важные цифры, суммы контрактов, даты и имена собственные с оригинальным первоисточником. Только после успешной ручной проверки скопируйте итоговый результат или используйте встроенные функции платформы для экспорта готового ответа в удобном для вас формате (например, в Word или Excel).
Типичные ошибки пользователей при загрузке документации
Практика доказывает: даже самые продвинутые и дорогостоящие нейросетевые алгоритмы пасуют перед банальной небрежностью человека. Глубокое понимание частых, повторяющихся ошибок поможет вам сэкономить массу времени, нервных клеток и, что немаловажно, реальных денег на оплате коммерческих тарифов.
Первая и самая разрушительная по своим последствиям ошибка — это загрузка абсолютно нечитаемых, мутных сканов. Если лист мятой бумаги был сфотографирован на бюджетный смартфон при тусклом освещении, под острым углом, а текст смазан из-за дрогнувшей руки, базовые текстовые модели просто не смогут распознать ни единого слова. Для работы с подобным «мусором» нужны сверхмощные специализированные модули. Если у вас нет к ним доступа, постарайтесь максимально улучшить качество изображения перед загрузкой: обрежьте края, повысьте контрастность, переведите фото в черно-белый формат.
Вторая распространенная ошибка напрямую касается управления лимитами подписки. Пользователи сплошь и рядом игнорируют условия своих тарифных планов. К примеру, если в описании бесплатного плана сервиса четко указано жесткое ограничение в 10 сообщений в день, категорически не стоит тратить их на пустые, бессодержательные приветствия вроде «Привет, как дела?» или «Ты готов сегодня поработать со мной?». Каждая такая реплика сжигает драгоценную квоту. Сразу, первым же сообщением отправляйте прикрепленный файл и развернутый, содержательный запрос к нему.
Третья системная проблема — это избыточность предоставляемого контекста. Загружая монументальную книгу или годовой отчет на 500 страниц, пользователь просит нейросеть найти одну маленькую, незначительную деталь на третьей странице. Если выбранная платформа изначально не предназначена для работы с такими гигантскими объемами (то есть не поддерживает большие контекстные окна), она может попросту «забыть» начало документа в процессе обработки или сразу выдать системную ошибку превышения количества допустимых токенов. Всегда старайтесь давать интеллектуальной системе ровно столько вводной информации, сколько действительно необходимо для решения вашей конкретной задачи.
Четвертая, концептуальная ошибка — это слепое, абсолютное доверие к выданному результату. Использование нейросетей ни в коем случае не отменяет необходимости включать собственное критическое мышление. Если система по вашему запросу извлекает сложные финансовые показатели из запутанного годового отчета компании, финальную сверку этих цифр перед отправкой документа высшему руководству обязан проводить живой человек. Алгоритм, каким бы умным он ни был, может банально перепутать смежные столбцы в сложной многоуровневой таблице или неверно интерпретировать сноску, набранную мелким шрифтом.
Примеры промптов для эффективного извлечения данных
В сфере взаимодействия с искусственным интеллектом действует золотое правило: качество и полезность полученного ответа напрямую зависят от качества заданного вопроса. Профессиональный промпт (запрос) должен быть максимально структурированным, недвусмысленным, лишенным лирических отступлений и содержать строгие указания на формат желаемого результата. Если вы планируете в дальнейшем использовать полученные и обработанные данные для публичных выступлений или защиты проектов, настоятельно советуем прочитать нашу подробную статью Нейросеть для презентаций: топ-6 сервисов, цены ₽ и доступ из РФ, чтобы узнать, как буквально за пару минут превратить сухой текст отчета в стильные слайды. А если в вашем исходном документе много фотографий или схем, которые необходимо очистить от лишних фоновых деталей перед вставкой в презентацию, вам отлично поможет материал Удалить фон с фото нейросетью: 6 лучших сервисов онлайн.
Ниже представлены проверенные шаблоны сложных запросов для решения различных профессиональных задач.
Для юристов, делопроизводителей и специалистов по контрактам:
«Действуй как опытный старший юрист корпоративного права. Внимательно проанализируй загруженный документ (договор долгосрочной аренды коммерческого помещения). Твоя задача состоит из двух частей: 1. Выписать абсолютно все основания для досрочного одностороннего расторжения договора со стороны арендодателя. 2. Найти и процитировать пункты, жестко регламентирующие порядок и сроки планового повышения арендной платы. Итоговый ответ оформи в виде строгой markdown-таблицы, состоящей из двух колонок: "Суть юридического условия" и "Точный номер пункта в тексте договора".»
Для исследователей, аспирантов и студентов:
«Глубоко изучи прикрепленную научную статью по социологии. Составь для меня исчерпывающее, но краткое резюме (строго до 250 слов), которое четко отражает главную гипотезу данного исследования и итоговые выводы, к которым пришли авторы. После текстового резюме перечисли все применяемые в работе методы сбора и анализа эмпирических данных маркированным списком. В процессе написания избегай чрезмерно сложных академических терминов, пиши понятным, живым языком, доступным для первокурсника.»
Для маркетологов, аналитиков и product-менеджеров (анализ цифровых отчетов):
«Перед тобой выгруженный маркетинговый отчет за прошедший квартал. Внимательно изучи весь текст и все вложенные таблицы. Найди точные числовые данные по трем конкретным показателям: общий израсходованный бюджет всех рекламных кампаний, средняя стоимость привлечения одного платящего клиента (CAC) и итоговый показатель возврата маркетинговых инвестиций (ROI). Выведи эти цифры списком. Если каких-то из этих конкретных данных объективно нет в документе, прямо и недвусмысленно напиши "Данные в отчете отсутствуют". Ничего не придумывай и не вычисляй самостоятельно, используй только готовые цифры из текста.»
Для работы с массивами текста (глубокая редактура и рерайтинг):
«Прочитай этот черновик статьи. Он написан слишком длинно, путано и содержит много воды. Твоя задача: профессионально сократить общий объем текста примерно на 30-40%, при этом обязательно сохранив все фактические данные, исторические даты, статистику и имена собственные. Попутно исправь все грамматические, пунктуационные и стилистические ошибки. Разбей итоговый, очищенный текст на удобочитаемые абзацы по смыслу и придумай к каждому такому абзацу короткий, цепляющий подзаголовок.»
Всегда важно помнить одну вещь: если итоговый результат вас чем-то не устроил с первого раза, совершенно не нужно удалять чат и писать длинный промпт заново. Просто попросите ИИ скорректировать текущий ответ в рамках того же диалога: «Текст получился слишком сложным, перепиши его проще, используя более короткие предложения» или «Ты забыл добавить колонку с датами в таблицу, пожалуйста, добавь ее сейчас».
Корпоративное применение и автоматизация документооборота
Когда речь заходит о масштабах среднего и крупного бизнеса, приоритеты и задачи меняются кардинально. Серьезные компании с многомиллионными оборотами не могут позволить себе роскошь вручную загружать каждый отдельный счет-фактуру или акт выполненных работ в окошко публичного чат-бота. Им требуются надежные конвейерные решения, способные работать в фоновом режиме круглосуточно, без перерывов на обед и выходных. Именно здесь на сцену выходят такие мощные профессиональные платформы, как Nlogic, Smart Engines и Преферентум, архитектура которых изначально заточена под высокие корпоративные нагрузки.
С технической точки зрения процесс глобальной автоматизации обработки первичной документации выглядит как сложный, хорошо отлаженный часовой механизм. Входящие электронные письма с PDF-вложениями от контрагентов или отсканированные в канцелярии папки бумаг автоматически по защищенным каналам направляются на выделенные сервера обработки. Там специализированные ИИ-платформы применяют обученные модели классификации для мгновенного определения типа документа (система сама понимает, что перед ней: акт сверки, транспортная накладная или счет на оплату). Затем алгоритмы находят на странице строго нужные поля (например, ИНН поставщика, итоговую сумму с НДС, дату документа, детальное наименование товара), считывают их и транслируют напрямую в учетные ERP-системы предприятия по API.
Безусловно, внедрение подобного высокотехнологичного подхода требует весьма значительных финансовых инвестиций на самом старте проекта. Компании оплачивают дорогие лицензии (как, например, в случае с тарифами от 190 000 ₽ в год за определенные объемы страниц или от 100 000 ₽ за продукты для глубокой текстовой аналитики), вкладывают серьезные человеческие и временные ресурсы во внедрение ПО, обучение моделей на собственной специфической базе документов и тонкую настройку интеграций с внутренними системами. Однако в среднесрочной и долгосрочной перспективе эти вложения многократно окупаются за счет колоссального снижения рутины: десяткам сотрудников бухгалтерии и бэк-офиса больше не нужно изо дня в день вручную, с риском опечаток, перепечатывать цифры с бумажных носителей в цифровые таблицы.
Для команд разработчиков, создающих современные мобильные и десктопные приложения, использование готовых коммерческих SDK (наборов средств разработки) становится золотым стандартом индустрии. Вместо того чтобы тратить годы работы целого отдела дата-саентистов и миллионы рублей на то, чтобы научить собственную нейросетевую модель стабильно распознавать бликующие на ярком солнце развороты паспортов или затертые, мятые штрихкоды на посылках, компания просто приобретает лицензию на готовый, отточенный годами движок и бесшовно встраивает его в интерфейс своего продукта всего за несколько недель.
FAQ: частые вопросы
Может ли искусственный интеллект прочитать отсканированный документ без текстового слоя?
Все всецело зависит от архитектуры конкретного выбранного сервиса. Обычные, стандартные языковые модели, которые вы используете в текстовых чатах, способны работать исключительно с изначально цифровым текстом (векторными шрифтами). Если же ваш загружаемый файл фактически состоит из сплошных картинок (сканов страниц), вам в обязательном порядке потребуется система со встроенным модулем оптического распознавания символов (OCR), либо мощные универсальные мультимодальные ИИ, умеющие анализировать изображения в составе загруженных PDF-файлов. Для постоянной, потоковой обработки сканов со сложной табличной структурой однозначно лучше использовать специализированные корпоративные платформы, которые не просто читают буквы, но и понимают геометрию страницы.
Безопасно ли загружать в такие системы конфиденциальные коммерческие контракты?
Вопрос информационной безопасности требует максимально внимательного, юридически выверенного изучения пользовательского соглашения каждого конкретного цифрового продукта. Бесплатные публичные чат-боты в подавляющем большинстве случаев собирают и используют загружаемые пользователями промпты и документы для дальнейшего дообучения своих языковых моделей, что абсолютно неприемлемо, если речь идет о коммерческой тайне, персональных данных клиентов или NDA. Корпоративные решения (особенно те, которые физически устанавливаются на локальные серверы заказчика по модели on-premise или используют строго изолированные, защищенные облачные контуры) обеспечивают полную конфиденциальность и отсутствие утечек, однако эти условия всегда нужно отдельно уточнять и фиксировать в договорах с разработчиками.
Как быстро обработать огромный архив, состоящий из нескольких тысяч страниц?
Привычные пользовательские веб-интерфейсы с маленьким окошком для загрузки файлов совершенно не подходят для таких индустриальных объемов — вы моментально столкнетесь с жесткими лимитами на максимальный размер одного файла и общее количество запросов в час. Для массовой, потоковой обработки применяются мощные корпоративные платформы автоматизации или прямое взаимодействие через API-интерфейсы. В таких сценариях взаимодействие происходит программным путем: ваш внутренний скрипт отправляет документы на сервер ИИ-провайдера большими пакетами в фоновом режиме, а система по мере готовности возвращает структурированный результат в виде удобных баз данных или JSON-файлов.
Существуют ли в природе полностью бесплатные решения вообще без ограничений?
Среди по-настоящему качественных и современных сервисов полностью бесплатных инструментов без каких-либо скрытых лимитов или рекламных модулей практически не существует. Это объясняется тем, что глубокий анализ текстов и работа нейросетей требует огромных, постоянных затрат на аренду вычислительных серверных мощностей. Однако многие клиентоориентированные платформы предоставляют стартовые бесплатные тарифы, которые обновляются регулярно. Например, есть отличные решения, позволяющие отправлять до 10 запросов в день абсолютно бесплатно (0 ₽), чего с лихвой достаточно для нерегулярного, эпизодического личного использования или выполнения домашних заданий.
Справятся ли современные алгоритмы с неразборчивым рукописным текстом и печатями?
Распознавание рукописного текста по-прежнему остается одной из самых сложных, ресурсоемких задач для вычислительных машин. Базовые ИИ-ассистенты и простые OCR-программы с ним, как правило, совершенно не справляются, выдавая набор случайных символов. Специализированные коммерческие SDK и тяжелые корпоративные системы распознавания обладают нужными модулями и способны извлекать данные из стандартизированных рукописных форм (например, заявлений), а также находить и классифицировать печати и подписи на странице. Но стоит понимать, что итоговая точность такого распознавания критически сильно зависит от разборчивости почерка автора и разрешения самого отсканированного изображения.
Имеет ли существенное значение изначальный формат, из которого был создан PDF-файл?
Да, это имеет колоссальное, подчас решающее значение для итогового результата. Документ, который был аккуратно сохранен напрямую из современного текстового редактора (например, функция "Сохранить как PDF" в Microsoft Word), содержит идеальный, кристально чистый векторный текст. Его анализ происходит машиной практически мгновенно и с максимальной точностью считывания каждого символа. Если же оригинальный документ был распечатан на принтере, подписан ручкой, затем пропущен через старый факс, а после этого небрежно отсканирован в низком разрешении, количество потенциальных ошибок при его расшифровке даже самой передовой нейросетью значительно возрастет из-за появления цифровых шумов и искажений.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.