Нейросеть для работы с аудиофайлами: обзор сервисов для обработки звука
Обзор нейросетей для работы с аудиофайлами: синтез речи, транскрибация, изменение голоса и звуковые эффекты — цены и условия доступа.
Содержание статьи7
- Что умеет нейросеть для работы с аудиофайлами
- Обзор сервисов для обработки звука
- Как выбрать нейросеть для работы с аудио под свою задачу
- Типичные ошибки при работе с нейросетями для аудио
- Пошаговый сценарий: от аудиофайла до готового результата
- Примеры запросов для синтеза и обработки аудио
- FAQ: частые вопросы
Если нужно превратить текст в живую речь, расшифровать интервью или на ходу изменить голос в эфире, выручит нейросеть для работы с аудиофайлами — такие сервисы берут на себя рутину, которую раньше делали вручную в аудиоредакторах. Одни модели синтезируют голос с нужной интонацией, другие распознают речь и переводят её в текст, третьи — меняют тембр или добавляют звуковые эффекты. Раньше на подобные задачи уходили часы в студии звукозаписи, а теперь результат можно получить за несколько минут через браузер.
В обзоре собраны сервисы для работы с аудио, которые решают разные задачи: от озвучки роликов до расшифровки встреч. Например, Звукограм совмещает синтез речи, транскрибацию и библиотеку звуковых эффектов, а Шёпот специализируется на переводе разговоров в текст с разметкой спикеров. Ниже — сравнительная таблица, подробный разбор каждого сервиса, типичные ошибки новичков и готовые сценарии применения такой нейросети для обработки звука, а также ответы на частые вопросы о ценах и доступе из России.
| Сервис | Для чего подходит | Цена | Бесплатный тариф | Доступ и оплата из РФ |
|---|---|---|---|---|
| Звукограм | Синтез речи из текста, транскрибация аудио, звуковые эффекты и музыка | Пополнение от 150 ₽ за 150 токенов (1 токен = 1 ₽) | Есть | Открывается без обходных путей, оплата картой РФ доступна |
| iMyFone MagicMic | Изменение голоса в реальном времени, эффекты для игр и стримов | От $9,99/мес | Есть | Уточняйте на сайте |
| Overdub | Синтез речи и клонирование голоса | От $0 (платные планы Descript — от $16/мес при годовой оплате) | Есть | Уточняйте на сайте |
| Silero TTS | Синтез речи, API для преобразования текста в аудио | Уточняйте на сайте сервиса | Уточняйте на сайте сервиса | Уточняйте на сайте |
| Steosvoice | Синтез речи и озвучка разными голосами | От $2/мес (есть планы за $6 и $10/мес) | Есть, ограниченный | Открывается без обходных путей, оплата — уточняйте на сайте |
| Шёпот | Расшифровка аудио и видео в текст, распознавание спикеров | От 2 ₽/мин или подписка от 390 ₽/мес (при оплате за год) | Есть, 30 минут бесплатно ежемесячно | Открывается без обходных путей, оплата — уточняйте на сайте |
Что умеет нейросеть для работы с аудиофайлами
Под одним названием скрываются сервисы с разными задачами. Часть из них генерирует речь из текста — это пригодится для озвучки видео, аудиокниг или подкастов без диктора. Другая часть, наоборот, превращает звук в текст: расшифровывает интервью, созвоны и лекции, причём некоторые сервисы дополнительно умеют различать, кто из участников разговора говорит в данный момент. Третья группа работает с самим голосом — меняет тембр в реальном времени или клонирует звучание конкретного человека для последующей генерации новых фраз без повторной записи.
Есть и узкоспециализированные инструменты — например, библиотеки звуковых эффектов и музыкальных подложек, которые подключаются через API или отдаются как готовый файл. Такие решения обычно встроены в более крупные платформы, а не существуют отдельно. Разобраться, какая именно нейросеть для обработки звука подойдёт, проще, если сразу понимать свою задачу: нужен ли готовый текст из записи, голос для видео, фильтр для стрима или программный доступ для встраивания в собственный продукт.
Отдельно стоит учитывать формат оплаты — где-то это разовое пополнение токенов, где-то подписка на месяц или год, а где-то индивидуальный расчёт стоимости для бизнеса. От этого напрямую зависит, насколько выгодным окажется сервис при разной интенсивности использования: разовая задача и ежедневная работа требуют разных тарифных моделей.
Обзор сервисов для обработки звука
Ниже — разбор каждого сервиса из таблицы: кому он подойдёт, в чём сильные стороны и какие есть ограничения по данным самих площадок. Разбор построен так, чтобы можно было сразу сопоставить задачу с конкретным инструментом, не пролистывая весь сайт сервиса в поисках нужной информации.
Звукограм: синтез речи, транскрибация и эффекты в одном месте
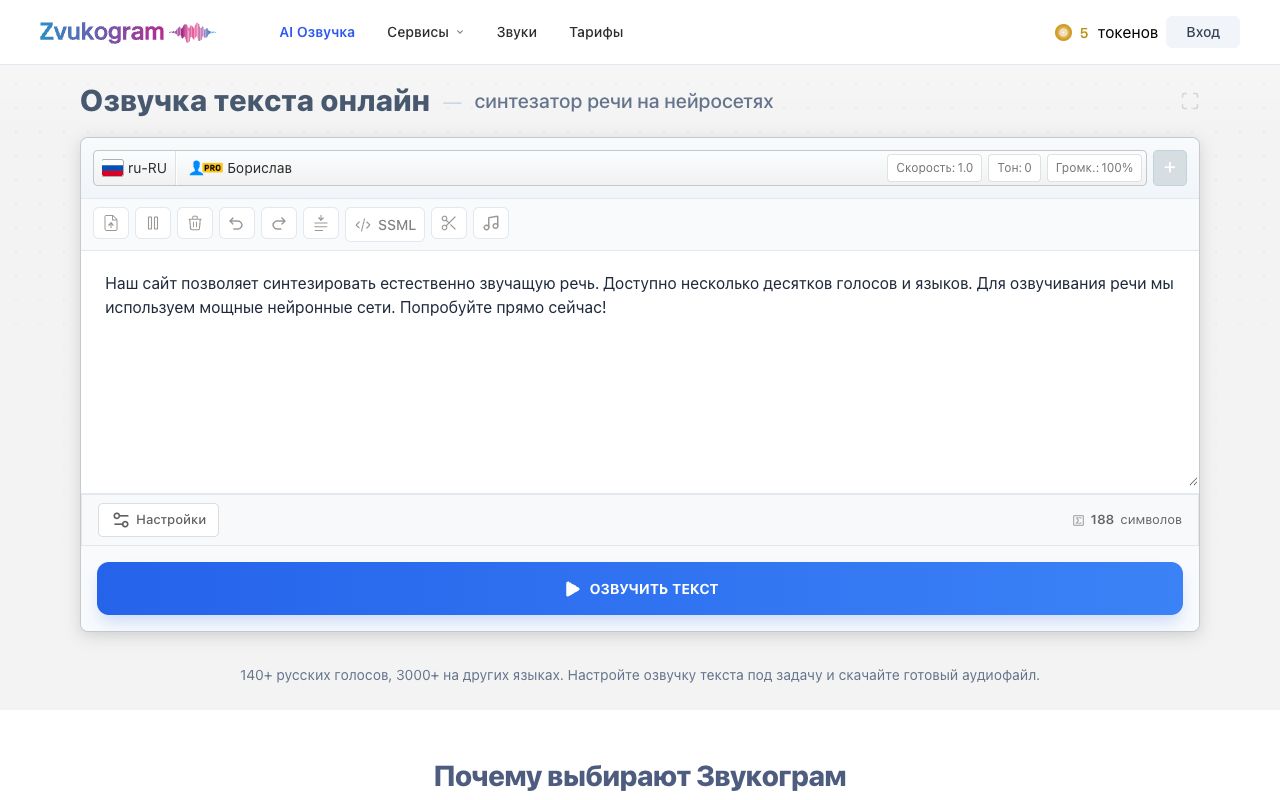
Звукограм удобен тем, кто не хочет держать отдельные инструменты для разных задач: сервис озвучивает текст голосом, расшифровывает уже готовые записи и предлагает библиотеку звуковых эффектов и музыки для скачивания. Это подходит для блогеров, которые делают озвучку роликов и параллельно хотят быстро получить текстовую версию интервью для субтитров или статьи, а также для небольших команд, которым важно не тратить бюджет на отдельные подписки под каждую задачу.
Оплата устроена через токены: пополнение от 150 ₽ за 150 токенов, где 1 токен равен 1 рублю. Подписки на месяц здесь нет — платите только за то, что использовали. Такой подход удобен для нерегулярных задач: если в этом месяце нужно озвучить один ролик, а в следующем — расшифровать два интервью, нет смысла переплачивать за фиксированный тарифный план. Сервис открывается без обходных путей, оплата картой РФ работает, что снимает часть вопросов при выборе.
Ограничение — токенная модель может оказаться не всегда предсказуемой по стоимости, если часто обрабатывать длинные файлы: перед масштабным проектом стоит прикинуть, сколько токенов уйдёт на типовую задачу, и протестировать расход на небольшом фрагменте, прежде чем загружать весь объём материала.
iMyFone MagicMic: изменение голоса для стримов и игр
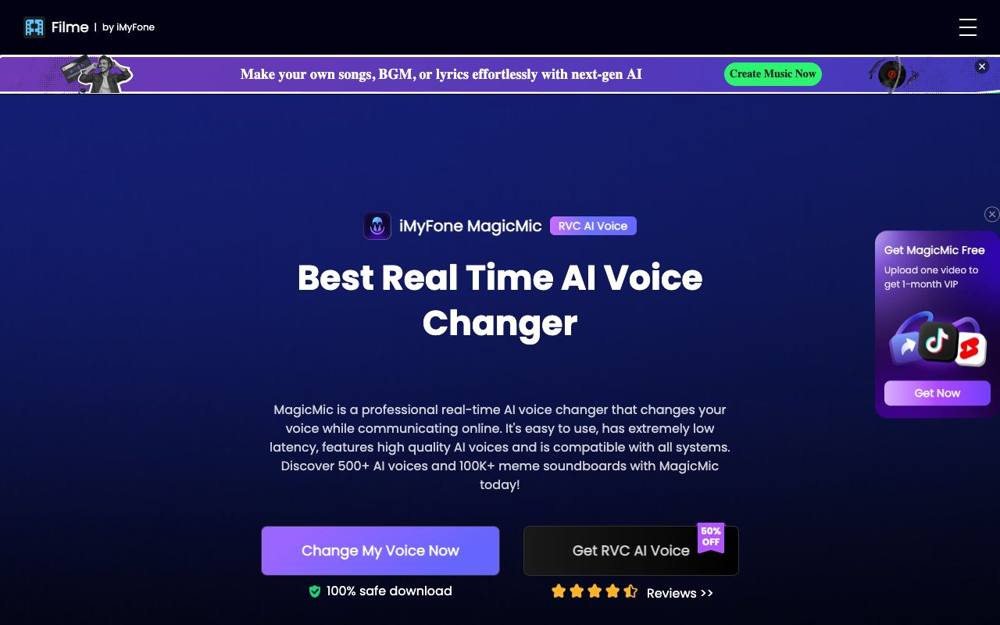
iMyFone MagicMic — это инструмент не для синтеза речи, а для её искажения в реальном времени. С помощью AI-фильтров можно менять голос во время стрима, игрового чата или видеозвонка, добавляя при этом готовые звуковые эффекты. Такой сервис уместен для стримеров, которые хотят скрыть реальный тембр или добавить игровую подачу голоса без монтажа постфактум, а также для создателей контента, которым нужна интерактивная звуковая дорожка прямо во время эфира.
Платная версия стоит от $9,99 в месяц, также есть годовой и пожизненный планы — выгоднее для тех, кто планирует использовать фильтры постоянно, а не разово. Бесплатный тариф тоже есть, что позволяет протестировать базовые функции перед покупкой и понять, подходит ли качество фильтров под конкретный сценарий — например, для озвучки персонажа в игровом стриме.
Доступ из России и способ оплаты картой РФ сервис не раскрывает публично — это стоит уточнить на сайте перед подпиской, особенно если планируется оформить годовой или пожизненный план сразу, а не ограничиться бесплатной версией.
Overdub: клонирование голоса и генерация речи из текста
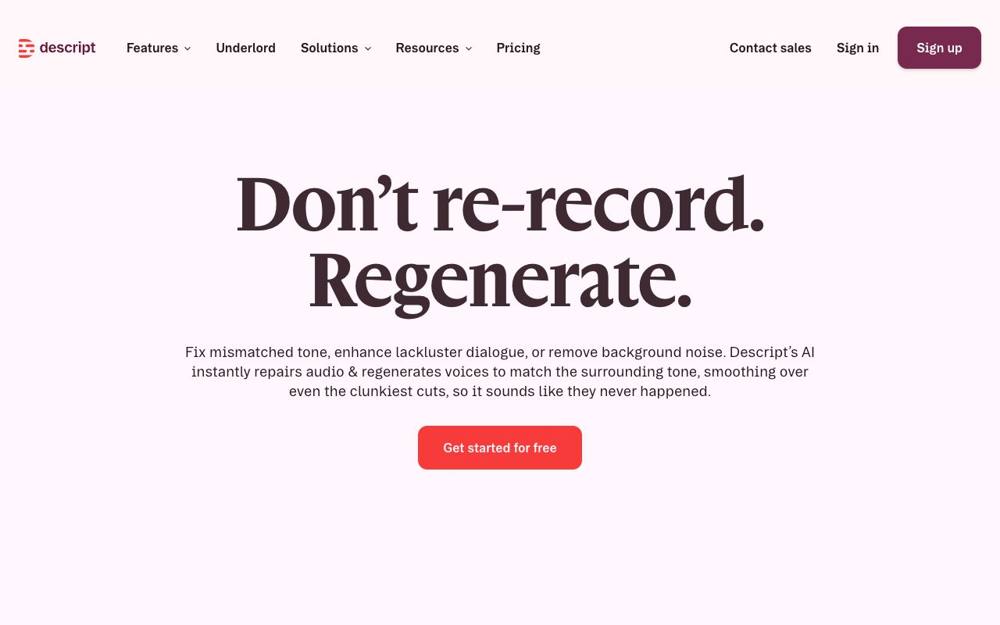
Overdub — часть экосистемы Descript, заточенная на генерацию реалистичной речи и правку голосовых записей текстом. Особенность — возможность клонировать собственный голос, после чего можно «переозвучивать» фразы, просто редактируя текст, а не перезаписывая аудио заново. Это удобно для подкастеров и авторов видео, которым нужно исправить оговорку без повторной записи в студии, а также для тех, кто готовит образовательные курсы и регулярно вносит правки в уже записанные уроки.
Бесплатный тариф стоит $0 в месяц и даёт базовый доступ, а платные планы Descript начинаются от $16 в месяц при годовой оплате — то есть ощутимо дороже базовых TTS-сервисов, но оправдано набором функций по монтажу и правке голоса. Для тех, кто работает с видео и аудио одновременно, это может заменить сразу несколько отдельных инструментов, объединив редактирование и озвучку в одном рабочем процессе.
Доступ из России и оплата картой РФ сервисом не уточняются, поэтому перед использованием стоит проверить это на сайте, особенно если планируется оформлять платный план сразу на год.
Silero TTS: синтез речи через API для бизнеса
Silero TTS отличается от большинства сервисов в списке тем, что ориентирован не на разовых пользователей, а на интеграцию в продукты: компании подключают синтез речи через API, чтобы озвучивать голосовых помощников, IVR-системы или приложения. Подойдёт разработчикам и командам, которым нужен не веб-интерфейс, а программный доступ к преобразованию текста в аудио, встроенный непосредственно в собственный сервис или мобильное приложение.
Стоимость коробочного и облачного варианта рассчитывается индивидуально по запросу — фиксированных тарифов в открытом доступе нет, поэтому цену и наличие бесплатного тестового периода нужно уточнять на сайте сервиса. Такой формат типичен для B2B-решений, где итоговая стоимость зависит от объёма запросов, количества голосов и способа развёртывания — облачного или локального.
Это же касается доступа из России и способа оплаты — условия стоит обсуждать напрямую с командой сервиса, так как публичной информации по этим пунктам нет.
Steosvoice: озвучка текста разными голосами
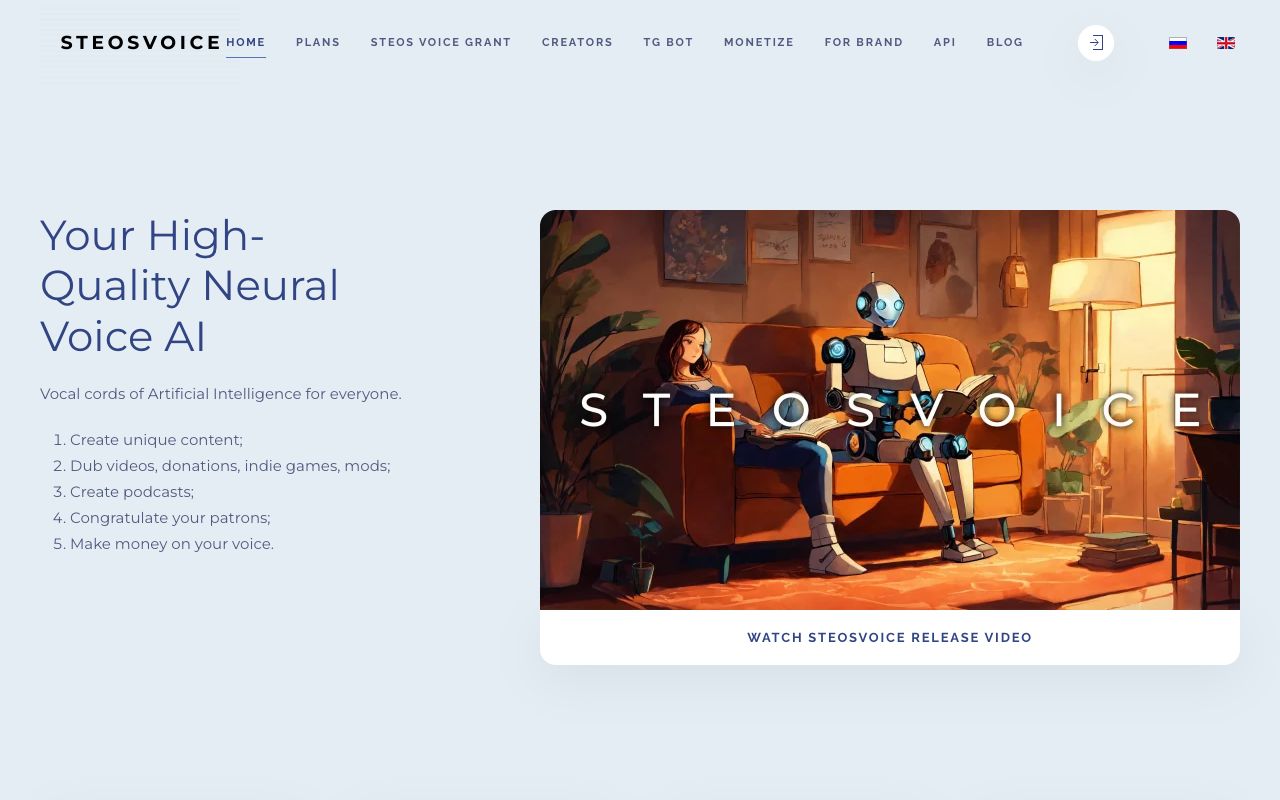
Steosvoice — сервис синтеза речи с набором голосов для озвучки текстов: подойдёт тем, кто делает видео на YouTube, аудиогиды или учебные материалы и хочет выбрать интонацию и тембр под конкретный ролик. Набор голосов позволяет подбирать звучание отдельно под рекламный ролик, спокойное обучающее видео или динамичный анонс — не прибегая к живому диктору.
Бесплатный доступ ограничен, но позволяет протестировать качество синтеза перед покупкой подписки. Платные тарифы начинаются от $2 в месяц, также доступны планы за $6 и $10 в месяц — разница обычно в объёме символов для озвучки и количестве доступных голосов, точные лимиты каждого плана стоит смотреть на сайте, прежде чем выбирать тариф под объём своих задач.
Сервис открывается из России без обходных путей, а условия оплаты картой РФ нужно уточнять отдельно — это особенно важно для тех, кто планирует оформить платный тариф, а не ограничиваться бесплатным тестовым доступом.
Шёпот: расшифровка аудио и видео в текст
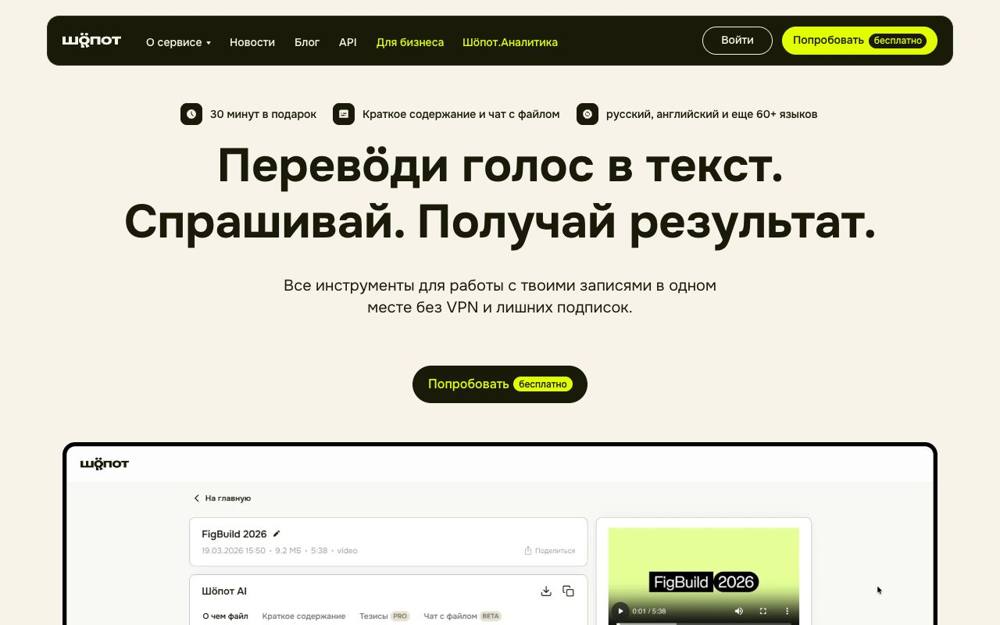
Шёпот — специализированный инструмент транскрибации: переводит аудио и видео в текст, распознаёт отдельных спикеров в разговоре и готовит тезисы по встрече. Это удобно для тех, кто ведёт переговоры, интервью или командные созвоны и не хочет вручную расшифровывать записи, а также для журналистов и исследователей, которым нужно быстро получить текстовую версию длинного разговора для последующей цитаты или анализа.
Каждый месяц доступно 30 минут бесплатной расшифровки, далее — оплата от 2 ₽ за минуту либо подписка от 390 ₽ в месяц при оплате за год. Для разовых задач выгоднее платить за минуты, а для регулярной расшифровки созвонов — взять подписку, особенно если встречи проводятся еженедельно и объём аудио стабильно превышает бесплатный лимит.
Сервис открывается без обходных путей, что заметно упрощает работу из России. Если нужен более широкий обзор инструментов для расшифровки, можно посмотреть статью про перевод аудио и видео в текст нейросетью, где рассмотрены дополнительные варианты и особенности их работы.
Как выбрать нейросеть для работы с аудио под свою задачу
Прежде чем регистрироваться в сервисе, стоит определить, что важнее: скорость получения результата, качество звучания голоса или гибкость тарифов. Если задача — быстро расшифровать интервью, подойдут инструменты транскрибации вроде Шёпота, а не универсальные платформы с большим набором функций, которые не нужны для одной задачи. Чем уже и конкретнее задача, тем проще выбрать подходящий сервис, не тратя время на изучение лишних возможностей.
Для синтеза речи важно послушать демо-озвучку голосов перед покупкой подписки: у Steosvoice и Звукограма доступны бесплатные режимы, которые позволяют оценить качество без оплаты. Стоит обратить внимание не только на общее звучание голоса, но и на то, как модель справляется с цифрами, аббревиатурами и именами собственными — именно на таких деталях синтез речи чаще всего «спотыкается».
Если нужен именно собственный клонированный голос для регулярной работы с видео, логичнее смотреть в сторону Overdub, где такая функция заявлена явно. А для задач, где важна программная интеграция, а не отдельный веб-интерфейс, стоит обратить внимание на Silero TTS — особенно если планируется встроить синтез речи в собственное приложение или голосового помощника.
Отдельный критерий — доступ из России и способ оплаты. Сервисы с прямым доступом и оплатой картой РФ, такие как Звукограм, снимают лишние вопросы на старте. У остальных условия доступа и оплаты нужно проверять непосредственно на сайте перед подпиской, особенно если планируется долгосрочное использование и оформление годового тарифа.
Если задача шире — не просто обработать голос, а создать музыкальное сопровождение к проекту, полезно заглянуть в статью про нейросети для создания музыки и ремиксов, где собраны отдельные сервисы именно под эту цель, а не под работу с голосом или транскрибацию.
Типичные ошибки при работе с нейросетями для аудио
Первая распространённая ошибка — выбирать сервис только по цене, не проверив качество синтеза или точность распознавания речи на своём материале. Голос с сильным акцентом, фоновый шум или несколько говорящих одновременно могут заметно снизить точность транскрибации даже у хороших сервисов — стоит протестировать короткий фрагмент перед тем, как загружать весь архив записей, чтобы не переплачивать за обработку, которую потом придётся переделывать вручную.
Вторая ошибка — не учитывать формат оплаты. Токенная система вроде у Звукограма удобна для разовых задач, но при постоянной большой нагрузке может обойтись дороже фиксированной подписки. И наоборот — месячная подписка, например у iMyFone MagicMic, выгодна только если использовать сервис регулярно, а не один раз в несколько месяцев, когда разовая оплата окажется дешевле.
Третья ошибка — игнорировать условия доступа из России. Если сервис не раскрывает это публично, как часть инструментов из обзора, стоит проверить работоспособность и возможность оплаты картой РФ до того, как оформлять платный план, а не после — это позволит избежать ситуации, когда деньги уже списаны, а воспользоваться сервисом не получается.
Четвёртая ошибка — пытаться клонировать голос или синтезировать речь без проверки итогового результата на слух. Автоматическая генерация иногда даёт неестественные паузы или интонации, особенно на длинных и сложных предложениях — лучше разбивать текст на короткие фрагменты и слушать каждый отдельно, чтобы вовремя заметить неудачные места и переформулировать текст.
Пятая ошибка — загружать в сервис транскрибации сразу большой объём записей без предварительной проверки настроек распознавания спикеров. Если участников разговора несколько, стоит сначала протестировать распознавание на коротком отрывке — это помогает понять, насколько точно сервис различает голоса, прежде чем доверять ему расшифровку многочасовой встречи.
Пошаговый сценарий: от аудиофайла до готового результата
Рассмотрим типовой сценарий — подготовка озвученного ролика с субтитрами на основе текстового сценария и записанного интервью. Такой маршрут часто встречается у блогеров и небольших видеокоманд, которым нужно совместить сразу несколько задач: озвучку, расшифровку и финальную сборку.
- Готовите текст сценария и загружаете его в сервис синтеза речи, например Звукограм или Steosvoice, выбираете подходящий голос и темп озвучки под формат ролика.
- Прослушиваете черновую озвучку, корректируете формулировки там, где интонация звучит неестественно, и пересобираете аудио — обычно достаточно переформулировать одно-два предложения, чтобы синтеззвучал ровнее.
- Если в проекте есть запись интервью, загружаете её в инструмент транскрибации — например, Шёпот — чтобы получить текст с разметкой спикеров и не тратить время на расшифровку вручную.
- Редактируете расшифровку, убираете слова-паразиты и повторы, формируете итоговый текст для субтитров или статьи, проверяя, чтобы смысл реплик каждого спикера сохранился.
- При необходимости добавляете звуковые эффекты или фоновую музыку из библиотеки сервиса синтеза речи, чтобы ролик звучал законченно и не был монотонным от начала до конца.
- Собираете финальный файл в видеоредакторе, проверяете синхронизацию озвучки с видеорядом и субтитров с речью — особенно в местах, где текст был отредактирован после первой генерации.
Такой маршрут подходит для блогеров и небольших команд, которым не требуется студия записи — большую часть работы берёт на себя нейросеть для обработки аудио, а человеку остаётся контроль качества и финальная сборка материала.
Примеры запросов для синтеза и обработки аудио
Чёткая формулировка задачи заметно влияет на качество результата, даже если сервис не работает с текстовыми промптами в привычном смысле, а предлагает настройки голоса и стиля через интерфейс. Вот несколько примеров того, как формулировать задачи для разных сценариев:
- Для озвучки обучающего видео: «спокойный мужской голос, средний темп, без эмоциональных акцентов, паузы между абзацами 1–2 секунды».
- Для рекламного ролика: «энергичный женский голос, короткие фразы, чёткое произношение цифр и названий брендов».
- Для транскрибации деловой встречи: загружаете запись с явным разделением говорящих по времени — это помогает сервисам типа Шёпота точнее распознавать отдельных спикеров и не путать реплики между собой.
- Для изменения голоса на стриме: выбираете готовый фильтр, близкий по тембру к желаемому эффекту, и тестируете его на коротком фрагменте речи перед прямым эфиром, чтобы убедиться в стабильности звучания.
- Для клонирования голоса: записываете чистый образец без шума и музыки длительностью, достаточной для обучения модели — чем чище исходник, тем естественнее звучит результат при дальнейшей генерации фраз.
- Для озвучки аудиокниги: подбираете голос с ровным, неторопливым темпом и проверяете, как сервис расставляет паузы на знаках препинания — от этого зависит, насколько комфортно будет слушать длинный текст.
Если же в проекте важна не только речь, а визуальная часть — например, обложка для подкаста без фона, — может быть полезна статья про удаление фона с фото нейросетью, которая закрывает смежную задачу оформления готового материала.
FAQ: частые вопросы
Какая нейросеть для работы с аудиофайлами подходит для транскрибации деловых встреч?
Для расшифровки разговоров с несколькими участниками подходит Шёпот — сервис распознаёт отдельных спикеров и готовит тезисы по итогам записи, при этом доступно 30 минут бесплатно каждый месяц.
Можно ли бесплатно синтезировать речь из текста?
Бесплатные тарифы или ограниченный доступ есть у Звукограма, Overdub и Steosvoice — они позволяют протестировать качество озвучки без оплаты, но с ограничениями по объёму или функциям.
Какой сервис подходит для клонирования собственного голоса?
Функция клонирования голоса заявлена у Overdub — сервис позволяет создать цифровую копию голоса и дальше генерировать речь, редактируя текст, а не перезаписывая аудио заново в студии.
Есть ли нейросети для изменения голоса в реальном времени?
Да, для этого предназначен iMyFone MagicMic — сервис применяет AI-фильтры к голосу во время стрима, игры или звонка и дополнительно предлагает готовые звуковые эффекты для контента.
Подходят ли эти сервисы для интеграции в собственное приложение?
Для интеграции через API ориентирован Silero TTS — стоимость коробочного и облачного решения рассчитывается индивидуально, поэтому условия нужно уточнять напрямую на сайте сервиса перед подключением.
Какие сервисы из обзора открываются из России без ограничений?
Без обходных путей открываются Звукограм, Steosvoice и Шёпот; доступ из России и условия оплаты у остальных сервисов — iMyFone MagicMic, Overdub и Silero TTS — стоит уточнять напрямую на сайтах перед регистрацией и оформлением платного тарифа.
Комментарии
Пока нет комментариев. Задайте вопрос или поделитесь опытом — ответим и дополним статью.